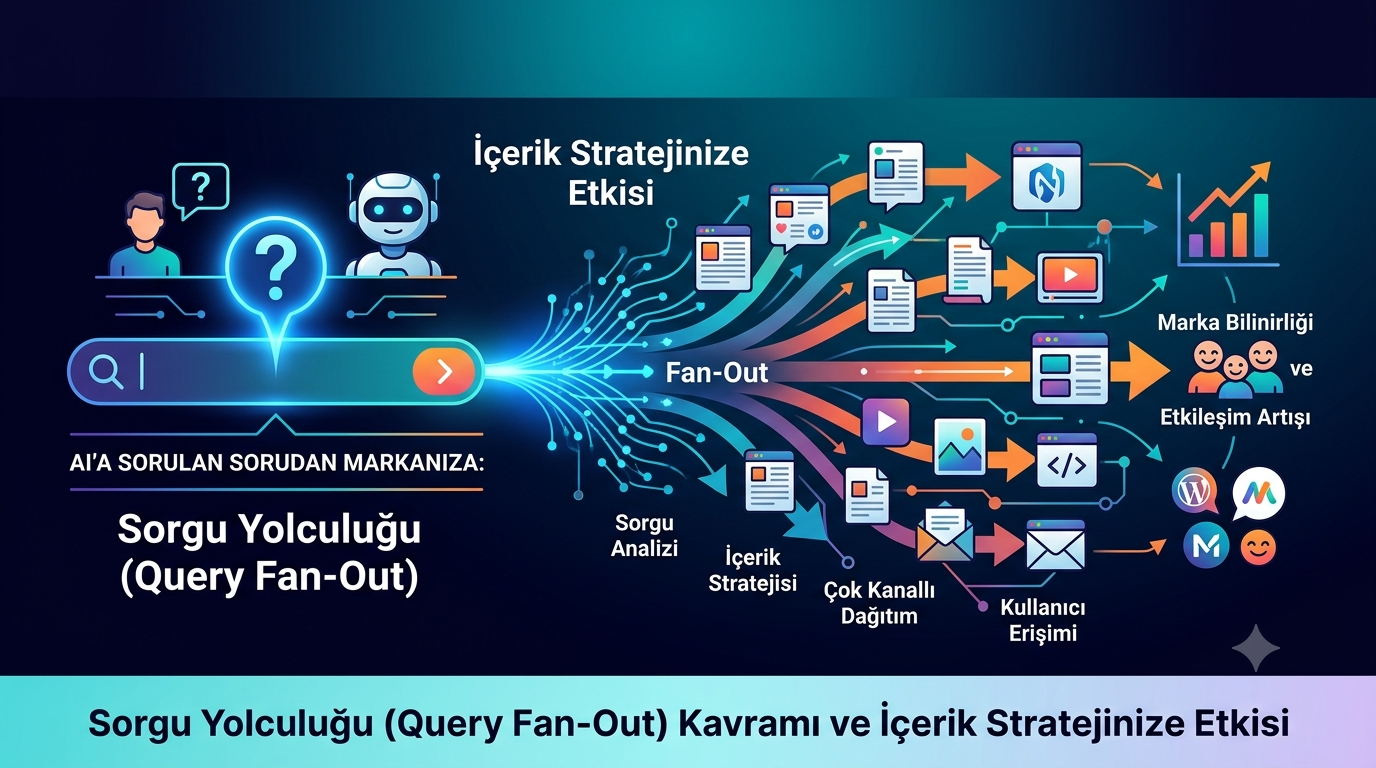
Yapay zekâ arama motorlarına a Sorulan tek bir soru, arka planda tek bir yanıt üretmez; model o soruyu alt sorulara bölerek onlarca farklı sorgu üretir ve yanıtı bu sorguların sonuçlarından birleştirir. Bu davranışa sorgu yolculuğu ya da İngilizce adıyla query fan-out denir. Kısaca tanım: kullanıcı tek cümle yazar, arama katmanı ise o cümleden türeyen çok sayıda alt sorguyu ayrı ayrı işler ve tek bir yanıtta toplar.
Bu yolculuk, klasik anahtar kelime mantığınızı sarsar. Bir kullanıcı “hangi boya dış cephede daha uzun dayanır” diye sorduğunda, model yalnızca bu cümleyi değil; marka karşılaştırmaları, uygulama koşulları, dayanıklılık testleri ve fiyat aralıkları gibi alt sorguları da çalıştırır. Markanızın bu alt sorguların herhangi birinde görünür bir kaynağı yoksa, üretilen yanıtta adınız geçmez.
Bu giriş yazısında sorgu fan-out kavramını, içerik planlamasına etkisini, hangi sayfa türlerinin bu yolculukta öne çıktığını ve nerede sınırların başladığını sırasıyla ele alacağım. Yanıtların koşullara bağlı olduğunu baştan söyleyeyim: hiçbir yapılandırma belirli bir sıralama garantisi vermez.
Yapay zeka aramalarında kullanıcıların sorduğu sorular, markanızın görünürlüğünü belirliyor. Bu rehber, sorgu yolculuğunu ölçmek ve içerik stratejinizi buna göre kurmak için gereken metrikleri, eşikleri ve araçları adım adım anlatıyor.
Sorgu Yolculuğu Ölçümünde İlk 30 Günde Neye Bakılır?
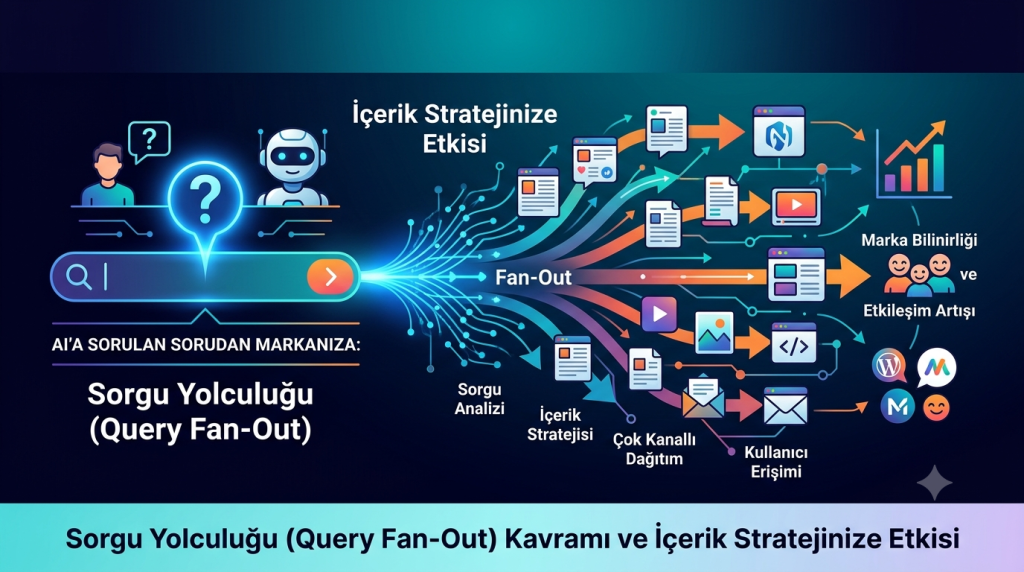
Sorgu yolculuğu, bir kullanıcının AI asistanına yönelttiği tek bir sorunun, modelin içinde birden çok alt sorguya ayrılması ve yanıtın bu alt sorgulardan sentezlenmesidir. Ölçümün amacı, markanızın bu alt sorguların hangilerinde yanıtın parçası olduğunu görmektir. İlk 30 gün bir performans dönemi değil, başlangıç çizgisini netleştirme dönemidir. Bu yüzden erken günlerde sıralama değil, görünürlük kaydı tutulur.
İlk 30 günde hedef, markanın hangi sorularda yanıt içinde geçtiğini belgelemektir. Karar ve bütçe aşaması bu kayıtların üzerine kurulur.
Başlangıç ölçümü: Hangi sorular markanızı tetikliyor?
Önce en az 20 anahtar soru belirleyin ve bu soruları haftalık olarak test edin. Soruları üç grupta toplayın: kategori soruları, karşılaştırma soruları ve satın alma öncesi sorular. Her grupta hem marka adı geçen hem de geçmeyen varyantlar olsun. Böylece markanın kendi adıyla değil, konu üzerinden ne kadar göründüğünü ayırt edebilirsiniz.
AI görünürlük izleme araçlarıyla markanızın hangi sorularda yanıt içinde geçtiğini kaydedin. Her testte şu dört alanı not edin: soru metni, yanıtın markayı anıp anmadığı, hangi kaynakların gösterildiği ve yanıtın tarihi. Aynı soruyu farklı oturumlarda sormak, modelin tutarlılığını görmenizi sağlar. Kayıtları tek bir tabloda tutun, dağınık notlar karşılaştırmayı zorlaştırır.
Temel metrikler ve kabul edilebilir aralıklar
Kabul eşiği olarak markanızın ilgili sorularda yanıtların yüzde 30’undan fazlasında görünmesini hedefleyin. Yüzde 10’un altı risk olarak işaretlenir; bu banttaki sorular öncelikli içerik işine girer. Bu eşikler bir garanti değil, ekip içi çalışma ölçütüdür. Sektöre, soru zorluğuna ve modelin kaynak tercihlerine göre sapma görülebilir.
| Metrik | Hedef | Risk |
|---|---|---|
| Yanıtta görünme | %30 üzeri | %10 altı |
| Soru kapsamı | 20+ soru | 10 altı |
| Kaynak gösterimi | En az 1 sayfa | Hiç yok |
| Yanıt tutarlılığı | Haftalar arası dengeli | Sıfır görünme |
Ölçüm sıklığı net olsun: haftalık manuel kontrol, aylık otomatik rapor. Manuel kontrolde soru metnini değiştirmeden aynı ifadeyi kullanın, aksi halde veri karşılaştırılamaz. Otomatik rapor için görünürlük izleme aracının hangi modelleri ve hangi tarih aralığını kapsadığını yazılı tutun. Modelin yanıtları zamanla değişebilir, bu yüzden tarih damgası olmadan kayıt anlamsızlaşır.
İlk 30 gün için kontrol listesi
- 20+ anahtar soruyu üç gruba ayırıp listeye alın.
- Her soru için marka adlı ve marka adsız varyant oluşturun.
- Haftalık test takvimini ve sorumluyu belirleyin.
- Görünme, kaynak ve tarih alanlarını içeren tek bir kayıt tablosu açın.
- %10 altındaki soruları risk listesine taşıyın.
- İlk ayın sonunda tabloyu gözden geçirip içerik önceliklerini güncelleyin.
Sınırlar: Bu yaklaşım, AI yanıtlarının sabit olduğu varsayımıyla çalışmaz. Modeller güncellenir, kaynak tercihleri değişir ve aynı soru farklı oturumlarda farklı yanıt üretebilir. Küçük soru setleriyle elde edilen oranlar tüm arama davranışını temsil etmez. Ayrıca görünürlük, tıklama veya satış anlamına gelmez; yalnızca yanıt içinde anılma durumunu gösterir.
Riskler: Yalnızca AI yanıtlarına göre içerik planı kurmak, klasik arama trafiğini gözden kaçırmaya yol açabilir. Ölçüm aracının hangi modeli kullandığını bilmemek yanlış karşılaştırma üretir. Bu yöntem, henüz ürün ve kategori sayfası olmayan yeni siteler için uygun değildir; önce temel sayfa yapısı gerekir. Hukuki veya finansal tavsiye içeren sorularda yanıt görünürlüğünü hedeflemek, mevzuata uygunluk kontrolü olmadan yapılmamalıdır. Bu içerik bilgilendirme amaçlıdır, uzman görüşü yerine geçmez.
AI’a Sorulan Soruları Sınıflandırma Tablosu
AI’a sorulan soruları dört gruba ayırmak, içerik önceliğini belirlemenin en hızlı yoludur: bilgi, karşılaştırma, işlem ve marka odaklı sorular. Her grup farklı bir arama niyeti taşır ve marka görünürlüğüne farklı biçimde etki eder. Sınıflandırma yapılmadan üretilen içerik, çoğu zaman yüksek hacimli bilgi sorularını atlar. Aşağıdaki tablo, dört soru tipini örnek, etki ve öncelik ekseninde karşılaştırır.
| Soru tipi | Örnek | Görünürlük etkisi | Öncelik |
|---|---|---|---|
| Bilgi | “X nedir, nasıl çalışır” | Yüksek hacim, geniş erişim | 1 |
| Karşılaştırma | “X mi Y mi, hangisi daha uygun” | Satın alma niyeti, dönüşüm | 2 |
| İşlem | “X nasıl yapılır, adımları neler” | Uygulama aşaması, bağlılık | 3 |
| Marka | “Marka X güvenilir mi” | İtibar, algı yönetimi | 4 |
Soru tipleri ve marka görünürlüğüne etkisi
Bilgi soruları, AI’a sorulan soruların hacim olarak en büyük kısmını oluşturur. “Nedir, nasıl çalışır, ne işe yarar” kalıbındaki bu sorular, tanım ve açıklama içeren sayfaları öne çıkarır. Marka görünürlüğü için ilk hedef burasıdır, çünkü erişim geniştir ve rakip yoğunluğu görece düşüktür.
Karşılaştırma soruları satın alma niyeti taşır. “Hangisi daha iyi, farkı ne, hangi durumda tercih edilir” tipi sorgular, karar aşamasındaki kullanıcıyı gösterir. Dönüşüm olasıi yüksektir; tablo ve ölçüt bazlı içerik bu grupta öne çıkar.
İşlem soruları uygulama adımlarına odaklanır. Marka odaklı sorular ise doğrudan itibar yönetimiyle ilgilidir ve düzenli izlenmesi gerekir.
Hangi soru tipi öncelikli?
Sıralama net: önce bilgi, sonra karşılaştırma, ardından işlem, en sonda marka. Bilgi soruları marka görünürlüğünün tabanını kurar; bu taban olmadan karşılaştırma içeriği yeterli bağlam bulamaz.
- Bilgi: Hacim ve erişim için ilk sırada.
- Karşılaştırma: Dönüşüm için ikinci sırada.
- İşlem: Bağlılık ve tekrar ziyaret için üçüncü sırada.
- Marka: İtibar takibi için sürekli izleme.
AI’a sorulan soruları sınıflandırırken hacim ile niyet ayrımını karıştırmamak gerekir. Yüksek hacim çoğu durumda yüksek dönüşüm demek değildir.
Sınıflandırma sonrası ilk aksiyon
İlk adım, mevcut sorgu listesini dört gruba etiketlemektir. Ardından her grup için tek bir temsilci soru seçin ve o soruya verdiğiniz yanıtı kontrol edin. Yanıt kısa, tanım cümlesiyle başlıyor ve kaynak içeriyorsa o grup hazırdır.
- Sorguları dört tipe ayırın ve sayın.
- Her tip için bir örnek soru belirleyin.
- Örnek soruya verilen yanıtı tanım, kanıt ve bağlantı açısından kontrol edin.
- Eksik grubu, sıralamaya göre ilk içerik üretim hedefi yapın.
Bu dört adım, sınıflandırmayı tabloda kalmaktan çıkarıp uygulanabilir bir plana dönüştürür.
İçerik Stratejisinde Sorgu Yolculuğunu Yönetme
Sorgu yolculuğunu yönetmek, kullanıcının yapay zekaya sorduğu ana soruyu ve bu sorudan doğan alt sorguları ayrı ayrı yanıtlayan bir içerik yapısı kurmakla başlar. Yapay zekaya sorulan her soru, tek bir sayfayla değil, alt sorgulara karşılık gelen içerik bloklarıyla karşılanır.
Alt sorguları hedefleyen içerik mimarisi
Ana soruyu yanıtlayan sayfa, alt sorguların her biri için ayrı bir içerik bloğu içermeli. Her blok, ilgili alt soruyu tek cümlelik net bir tanımla açmalı; ardından ayrıntı, örnek ve koşul gelmeli.
Örneğin “KOBİ için e-fatura nasıl kesilir?” sorusunun alt sorguları şöyle dağılabilir: zorunluluk sınırı, başvuru adımı, iptal koşulu, ceza durumu. Her biri kendi başlığı altında, ana sorudan bağımsız okunabilecek biçimde yazılır. Yapay zekanın alıntılayacağı cümle bloğun ilk paragrafında yer alır ve 25 kelimeyi geçmez.
- Alt soru başına tek blok, tek konu.
- Blok başında tanım cümlesi, sonunda koşul veya istisna.
- İlgili bloklara iç bağlantı, ana sayfaya dönüş yolu.
Yapılandırılmış veri ve net tanım cümleleri
Soruların yanıtları hem görünür metinde hem de yapılandırılmış veride yer almalı. schema.org FAQPage ve HowTo işaretlemeleri, soru-cevap eşleşmesini makine tarafından okunur hale getirir.
Google’ın yapılandırılmış veri kuralları, işaretlenen içeriğin sayfada görünür olmasını şart koşar. Görünmeyen yanıtı işaretlemek geçersiz sayılır. Tanım cümlesi kısa, öznesi belli ve terimleri açık olmalı; “bu, şu anlama gelir” kalıbı yerine doğrudan tanım yazılmalı.
| Öğe | Kural |
|---|---|
| Tanım cümlesi | 25 kelime altı, blok başında |
| FAQPage | Soru ve yanıt görünür metinde |
| HowTo | Adımlar sıralı ve numaralı |
İçerik güncelleme sıklığı ve eşiği
Revizyon kararı tahminle değil, ölçümle verilir. Bir soruda görünürlük yüzde 20’nin altına düştüğünde içerik revizyonu yapılır. Rekabetçi sorularda güncelleme aylık, diğerlerinde üç aylık döngüde tutulur.
Revizyon önceliği şu sırayla belirlenebilir: düşüş oranı en yüksek soru, trafiği en yüksek soru, dönüşüme en yakın soru. Yapay zekaya sorulan soruların görünürlük verisi panelde izlenir; hangi bloğun önce elden geçeceği bu tabloyla netleşir. Ölçüm aracı ve sıklığı baştan yazılı olsun ki karşılaştırma sağlıklı kalsın.
- Görünürlük düşüşünü haftalık kontrol et.
- Yüzde 20 eşiğinin altındaki soruları listele.
- Tanım cümlesini ve alt blokları güncelle.
- Değişikliği dört hafta sonra yeniden ölç.
Bu içerik bilgilendirme amaçlıdır, uzman görüşü yerine geçmez.
Ölçüm Metrikleri ve Araçları: Karşılaştırma Tablosu
Sorgu yolculuğu ölçümünde iki temel yaklaşım var: manuel test ve otomatik izleme. Doğru seçim, soru hacminize ve bütçenize bağlı. AI’a sorulan soruların yanıtlarında markanızın görünürlüğünü takip etmek için önce hangi metrikleri izleyeceğinizi netleştirin.
Görünürlük oranı, alıntılanma sıklığı ve yanıt sırası, sorgu yolculuğu ölçümünün üç temel metriğidir. Bu üçü birlikte okunmadan tek başına hiçbiri anlamlı sonuç vermez.
Manuel test mi, otomatik izleme mi?
Manuel test, haftada 10 soruyu 3 farklı AI asistanına sormakla başlar. Maliyeti düşüktür, çünkü ek araç gerekmez. Ölçek sınırlıdır; soru sayısı arttıkça saat bazlı emek hızla büyür.
Otomatik izleme, aylık 100 ve üzeri soruyu API tabanlı olarak tarar. Maliyet orta ile yüksek arasında değişir. Karşılığında kapsam genişler ve tekrarlanabilir kayıt elde edersiniz. AI’a sorulan soruların yanıtları zaman içinde değiştiği için düzenli tekrar şart.
- Manuel test: Haftalık 10 soru, 3 asistan, düşük maliyet, dar kapsam.
- Otomatik izleme: Aylık 100+ soru, API tabanlı, orta-yüksek maliyet, geniş kapsam.
- Hibrit yaklaşım: Kritik 10 soruyu manuel, geniş listeyi otomatik izleyin.
Hangi metrik hangi araçla ölçülür?
Görünürlük oranı, markanızın belirli bir soru kümesinde kaç yanıtta geçtiğini gösterir. Manuel testte tablo tutarak, otomatik izlemede API yanıtlarını metin eşleştirmeyle tarayarak ölçülür. Alıntılanma sıklığı, yanıtın kaynak gösterip göstermediğine bakar. Yanıt sırası ise markanızın yanıt içinde kaçıncı sırada anıldığını kaydeder.
Google’ın yapay zeka özellikleri ve arama sonuçlarına ilişkin güncel belgeler, içeriğin kaynak olarak gösterilmesinin nasıl işlediğine dair genel çerçeve sunar. Google Search Central bu konuda başvurulabilecek resmi kaynaktır. Ölçüm aracınız ne olursa olsun, aynı soru listesini ve aynı tarih aralığını koruyun.
Maliyet ve doğruluk dengesi
Manuel test doğrulukta güçlüdür, çünkü yanıtı insan gözüyle okursunuz. Buna karşılık ölçek dar kalır. Otomatik izleme kapsamı büyütür, fakat metin eşleştirme hataları doğruluğu düşürebilir. Bu nedenle otomatik sonuçların bir kısmını manuel olarak doğrulayın.
| Ölçüt | Manuel | Otomatik |
|---|---|---|
| Maliyet | Düşük | Orta-yüksek |
| Doğruluk | Yüksek | Değişken |
| Kapsam | Dar | Geniş |
| Sıklık | Haftalık | Günlük veya aylık |
Bütçe kısıtlıysa haftalık manuel testle başlayın. Soru sayısı 50’yi geçtiğinde otomatik izlemeye geçiş planlayın. Doğrulama için her ay örneklem olarak 10 yanıtı elle kontrol edin.
Vaka: 300 Ürünlü E-ticaret Sitesinde Sorgu Yolculuğu Uygulaması
Bu vaka, 300 ürünlük bir e-ticaret sitesinin AI’a sorulan sorulardan gelen trafiği ölçülebilir hale getirme sürecini adım adım gösterir. Uygulama dört aşamada ilerler: soru belirleme, sınıflandırma, içerik boşluğu doldurma ve 30 günlük ölçüm. Amaç sıralama vaadi değil, hangi soru tipinde görünürlük kazanıldığını görmek.
Başlangıç durumu ve hedefler
Site 300 ürünü altı kategoride satıyor; ürün sayfaları dolu, kategori ve rehber sayfaları zayıf. Kullanıcıların AI asistanlarına ürün seçimi için soru sorduğunu, sitenin bu yanıtlarda geçmediğini tespit ediyorlar. Hedef, bilgi amaçlı sorularda görünmek ve karşılaştırma sorularında kaynak olarak anılmak.
Başlangıç ölçümü için üç metrik seçilir: AI yanıtlarında marka anılma sıklığı, rehber sayfalarının organik tıklaması ve ürün sayfası oturum süresi. Ölçüm elle yapılır; haftada bir aynı 20 soru üç farklı asistana sorulur ve yanıtlar kaydedilir.
Uygulama adımları ve alınan sonuçlar
Adım 1, 50 anahtar soru belirleme. Ürün yorumları, destek e-postaları ve site içi aramalardan gerçek soru cümleleri toplanır. “a sorulan” soruların çoğu ürün seçimi ve uyumluluk üzerinedir.
Adım 2, sınıflandırma. Sorular dört gruba ayrılır: bilgi, karşılaştırma, işlem ve sorun giderme. Her gruba kaç soru düştüğü tabloda görülür.
| Grup | Soru | Sayfa |
|---|---|---|
| Bilgi | 18 | Rehber |
| Karşılaştırma | 14 | Karşılaştırma |
| İşlem | 11 | Kategori |
| Sorun | 7 | SSS |
Adım 3, boşluk doldurma. Bilgi soruları için altı rehber, karşılaştırma soruları için dört karşılaştırma sayfası yazılır. Her sayfa tek bir soruya doğrudan yanıtla açılır, ardından ölçüt ve örnek eklenir.
Adım 4, 30 günlük ölçüm. Aynı 20 soru haftalık tekrarla izlenir; yeni sayfaların dizine girmesi Google Search Central üzerinden kontrol edilir. Yanıt biçimi kuralları için schema.org yapılandırma rehberi kullanılır.
Ölçüm çıktıları ve yorum
Beklenen çıktı iki başlıkta toplanır: bilgi sorularında görünürlük artışı, karşılaştırma sorularında alıntılanma. İlk 30 günde dizine girme tamamlanmadan yorum yapmak yanıltıcı olur; asistan yanıtları gecikmeli güncellenir.
- Haftalık kayıt: soru, asistan, marka anıldı mı, hangi URL kaynak gösterildi.
- Karşılaştırma sayfalarında ölçüt tablosu var mı, kontrol edilir.
- Rehber sayfalarında ilk paragraf soruya doğrudan yanıt veriyor mu, bakılır.
Ölçümde araç değil yöntem belirleyici: aynı soru seti, aynı sıklık, aynı kayıt biçimi. Bu disiplin olmadan artış ile dalgalanma ayrılmaz.
Sınırlar ve Riskler: Kimler İçin Uygun Değil?
Yapay zekâya sorulan sorular üzerinden içerik planlamak, sabit ve tekrar edilebilir bir mühendislik işi değildir; modelin yanıtı her sorguda yeniden üretilir. Bu bölüm, yöntemin nerede tıkandığını ve hangi profiller için erken bir yatırım olduğunu anlatıyor.
Ölçümün sınırları: AI modellerinin değişkenliği
Aynı soru, aynı gün içinde farklı yanıtlar üretebilir. Model sürümü, bağlam penceresi, kişiselleştirme ve hatta sohbet geçmişi yanıtı değiştirir. Bu yüzden tek bir ölçümü “sonuç” saymak yanıltıcıdır.
Sağlam bir ölçüm için şu disiplin gerekir:
- Tekrar sayısı: Her soruyu en az 3 farklı oturumda, tercihen farklı günlerde çalıştırın.
- Kayıt biçimi: Yanıtın tam metnini değil, marka adının geçip geçmediğini ve hangi kaynakların atıflandığını not edin.
- Değişkenlik oranı: Aynı soruda markanın görünme sıklığını yüzde olarak izleyin, tek seferlik gözlemi rapor saymayın.
Google’ın yapay zekâ yanıtlarının nasıl üretildiğine dair genel açıklamaları, yanıtların bağlama göre değiştiğini doğrular niteliktedir: Google Search Central.
Hangi durumda bu strateji işe yaramaz?
Çok niş veya düşük hacimli sorularda ölçüm gürültülü olur. Ayda birkaç kez sorulan bir soruda markanın görünüp görünmemesi, içeriğin kalitesinden çok rastlantıyı yansıtır.
Şu durumlarda yöntem beklentiyi karşılamaz:
- Hızlı sonuç beklentisi: İçeriğin dizinlenmesi, atıf alması ve modelin eğitim veya erişim havuzuna girmesi zaman alır. Etki genellikle 3-6 aylık aralıkta görünür hâle gelir.
- Dar bütçeli tek seferlik projeler: Ölçüm için düzenli tekrar gerekir; tek seferlik çalışma karşılaştırma zemini bırakmaz.
- Konu dışı otorite eksikliği: Sitenin konuyla ilgili geçmişi yoksa, sorulan sorularda atıf alma olasılığı düşük kalır.
Kritik kural: Yapay zekâya sorulan sorularda görünürlük, tek ölçümle değil, tekrarlı gözlem ve değişkenlik oranıyla değerlendirilir.
Yanlış uygulama riskleri
En sık yapılan hata, her yanıtta geçen ifadeleri sayfaya doldurmak. Aşırı optimizasyon, anahtar kelime yığılması olarak algılanabilir ve içeriğin güvenilirliğini zedeler. Google’ın spam politikaları bu tür davranışı açıkça tanımlar: Spam politikaları.
İkinci risk, ölçümü abartmak. Yanıt metnini kopyalayıp “AI bizi böyle anlatıyor” diye sunmak, kanıt değeri taşımaz. Üçüncü risk, kaynak göstermeden iddia yazmak; yapılandırılmış veri ve net atıf olmadan üretilen içerik, hem arama hem yanıt katmanında zayıf kalır. Şema kuralları için schema.org temel başvuru kaynağıdır.
Yöntem, yapay zekâya sorulan soruları düzenli izleyecek zamanı ve sabrı olan ekipler için anlamlı. Hızlı kampanya dönüşü arayanlar için uygun değil.
Adım Adım Kontrol Listesi: Sorgu Yolculuğunu Yönetme
Sorgu yolculuğunu yönetmek, AI asistanlarına sorulan soruların nerede başlayıp nerede markanıza bağlandığını düzenli aralıklarla izlemeyi gerektirir. Tek seferlik bir ölçüm yeterli olmaz; haftalık test, aylık değerlendirme ve tanımlı eşiklerle ilerlemek gerekir. Aşağıdaki kontrol listesi, bu döngüyü sürdürülebilir hale getirmek için tasarlandı.
Haftalık kontrol listesi
Her hafta aynı 10 anahtar soruyu en az 3 farklı AI asistanında test edin. Soruları önceden sabitleyin; böylece haftalar arası karşılaştırma anlamlı olur. Her testte soruyu birebir yazın, yanıtın markanızdan söz edip etmediğini ve hangi kaynağı gösterdiğini kaydedin. Sonuçları ortak bir tabloda tutun: tarih, asistan adı, soru, görünürlük durumu, alıntılanan URL.
- Soru listesini dondurun, hafta içinde değiştirmeyin.
- Yanıt ekran görüntüsünü veya metnini arşivleyin.
- Alıntılanan sayfanın sizin mi, rakibin mi olduğunu işaretleyin.
- Yeni ortaya çıkan soruları ayrı bir “aday” listesine ekleyin.
Haftalık testin değeri soru sayısından değil, tekrardan gelir. Aynı soruyu aynı asistanlarda düzenli sormak, AI’a sorulan sorulardaki değişimi görünür kılar.
Aylık değerlendirme kriterleri
Ay sonunda haftalık kayıtları tek bir rapora indirin. Üç metriği ayrı ayrı izleyin: görünürlük oranı (10 sorudan kaçında marka geçiyor), alıntılanma sayısı (kaç yanıt sizin URL’nizi kaynak gösteriyor) ve klasik arama sıralaması. Üçünü birlikte okumak, tek başına hiçbirinin göstermediği eğilimi ortaya çıkarır.
| Metrik | Ne ölçer | Kayıt sıklığı |
|---|---|---|
| Görünürlük oranı | Markanın geçtiği yanıt yüzdesi | Haftalık, aylık özet |
| Alıntılanma | Kaynak gösterilen URL sayısı | Haftalık |
| Sıralama | Hedef sorgudaki klasik konum | Aylık |
| Yanıt tutarlılığı | Asistanlar arası fark | Aylık |
Acil müdahale eşikleri
Bir soruda görünürlük %10’un altına düştüğünde içerik revizyonunu başlatın. Bu eşik, 10 soruluk sette o sorunun neredeyse hiç görünmediği anlamına gelir. Revizyonda önce sayfanın soruya doğrudan cevap verip vermediğine bakın; cevap ilk paragrafta yoksa ekleyin. Ardından kaynak ve yapılandırılmış veri eksiklerini kontrol edin.
- Soruyu yanıtlayan sayfayı belirleyin.
- İlk 100 kelimede net cevap var mı, doğrulayın.
- Rakibin alıntılanan sayfasıyla yapı farkını karşılaştırın.
- Revizyonu yayına alın, iki hafta sonra aynı soruyu yeniden test edin.
Eşiği geçen düşüşlerde panik revizyonu yapmayın. AI’a sorulan sorularda yanıtlar asistan güncellemeleriyle değişebilir; iki haftalık yeniden test, düşüşün kalıcı mı geçici mi olduğunu gösterir. Ölçüm yöntemini ve eşikleri yazılı tutun ki ekip aynı kriterle karar versin.
Marka Ses ve Mesajının Sorgu Yanıtlarına Etkisi
Yapay zeka, bir markayı alıntılarken en net ve en kısa tanım cümlesini seçer. Uzun, dolambaçlı anlatımlar modelin işine yaramaz; ilk cümlede ne olduğunuzu söyleyen içerikler alıntılanma şansını artırır. Bu yüzden marka sesi çalışması, sadece ton değil, alıntılanabilirlik sorunudur.
AI’a sorulan her soruda model, cevabı birden çok kaynaktan toplar. Bu toplama sırasında kısa ve tanım niteliğindeki cümleler öne çıkar.
Tutarlı tanım cümlesi neden gerekli?
Bir içerik bloğunun ilk paragrafında 25 kelimeyi geçmeyen bir tanım cümlesi bulunmalı. Bu cümle, sayfanın ne anlattığını tek solukta söyler ve modelin alıntılayacağı en olası metin parçası olur. Tanım cümlesi her sayfada aynı yapıyla kurulursa, marka farklı sayfalarda aynı bağlamda anılır.
Tutarsız tanımlar modeli yanıltır. Bir sayfada “danışmanlık şirketi”, diğerinde “yazılım sağlayıcı” olarak geçen marka, yanıt motorlarında belirsiz bir varlığa dönüşür. Tanım cümlesini tek bir kalıba oturtmak bu belirsizliği azaltır.
- Tanım cümlesini 25 kelimenin altında tutun.
- Aynı kalıbı tüm ana sayfalarda kullanın.
- Hizmet adını ilk cümlede geçirin.
- Abartılı sıfatlardan kaçının.
Mesaj mimarisinin ölçülebilir çıktıları
Mesaj mimarisi, markanın hangi konuda hangi cümleyle anılacağını önceden belirler. Bu yapı kurulduğunda AI’a sorulan sorularda markanın hangi bağlamda geçtiği izlenebilir hale gelir. Ölçüm için üç metrik yeterli: alıntılanma sıklığı, alıntı bağlamının doğruluğu ve tanım cümlesinin birebir tekrar oranı.
| Ölçüt | Ne ölçülür | Sıklık |
|---|---|---|
| Alıntı sıklığı | Markanın yanıtlarda geçme sayısı | Aylık |
| Bağlam doğruluğu | Doğru hizmetle anılma oranı | Aylık |
| Tanım tekrarı | Tanım cümlesinin birebir alıntısı | Çeyreklik |
Marka sesi ile AI alıntıları arasındaki ilişki
Marka sesi tutarlı olduğunda model, markayı doğru bağlamda anar. Ses tutarsızsa alıntı gelir ama yanlış hizmetle eşleşir. Bu ilişkiyi görmek için AI’a sorulan soruların yanıtlarını düzenli kaydedin ve bağlamı etiketleyin.
Uygulama sırası şöyle işler: önce tanım cümlesi kalıbını yazın, sonra tüm ana sayfalara uygulayın, ardından yanıtları toplayıp bağlam etiketleriyle karşılaştırın. Üç aylık döngüde bağlam doğruluğu artmıyorsa mesaj mimarisini yeniden gözden geçirin.
Alıntı sayısı tek başına başarı göstergesi değildir; doğru bağlamda alıntılanmak gerekir.
İlgili hizmetler ve kaynaklar
- Pixenon marka Stratejisi ve Yol Haritası Hizmeti
- Yapay Zeka Görünürlüğü
- AI Görünürlük İzleme ve Ölçümü (AI Share of Voice)
Pixenon, yapay zeka görünürlük analizini 8 kategori ve 300 kanıtlı kriter üzerinden yürütüyor; bu yazıdaki ölçütler o analiz başlıklarıyla aynı çerçeveyi kullanıyor.
Teknik ayrıntı için Google Search Central faydalı içerik rehberine, ölçüm notları için web.dev belgelerine ve yapay zeka tarayıcıları için llms.txt standardına bakabilirsiniz.
Sık sorulan sorular
Sorgu yolculuğu nedir ve neden önemli?
Sorgu yolculuğu, bir kullanıcının tek bir arama niyetinden yola çıkarak yapay zekânın ürettiği alt sorulara (fan-out) verdiği yanıtları izleme sürecidir. Kullanıcı asıl soruyu sorar, model konuyu parçalara ayırıp her parça için ayrı arama yapar ve yanıtı bu alt sorgulardan birleştirir. Bu yüzden markanızın yalnızca ana kelimede değil, türev sorularda da görünür olması gerekir.
AI'a sorulan soruları nasıl ölçerim?
AI'a sorulan soruları ölçmek, sabit bir soru setini düzenli aralıklarla farklı modellere sormak ve yanıtlarda marka geçişini kaydetmekle yapılır. Aynı soruyu haftalık tekrarlayın, yanıtı ekran görüntüsü veya metin olarak arşivleyin. Kaynak gösterilen siteleri ve atıf sıklığını not edin; böylece değişimi karşılaştırabilirsiniz.
Hangi araçlar AI görünürlüğünü izlemek için uygun?
AI görünürlüğünü izlemek için hazır izleme platformları, manuel soru setleri ve arama konsolu verileri birlikte kullanılabilir. Hazır araçlar marka bahsini otomatik tarar, ancak model yanıtları değişken olduğu için tek başına yeterli değildir. Google Search Central'ın yapılandırılmış veri ve içerik yönergeleri, hangi sayfaların alıntılanabilir olduğunu anlamak için temel referanstır.
Sorgu yolculuğu optimizasyonu ne kadar sürede sonuç verir?
Sorgu yolculuğu optimizasyonunun sonuç süresi sabit değildir; içerik güncellemesinin taranmasına ve modelin kaynak havuzunu yenilemesine bağlıdır. Yeni sayfaların dizine girmesi günler alabilir, model yanıtlarına yansıması ise daha uzun sürebilir. Bu nedenle ilk haftalarda ölçüm altyapısını kurmak, sonuç beklemekten daha doğru bir başlangıçtır.
Kimler için uygun değil?
Sorgu yolculuğu optimizasyonu, hızlı ve garantili sıralama artışı bekleyen markalar için uygun değildir. Ürün veya hizmeti hakkında doğrulanabilir bilgi yayımlamayan, içerik güncellemesine kaynak ayırmayan ekipler için de verimli sonuç vermez. Ölçüm yapmadan yalnızca anahtar kelime eklemeye odaklanan yaklaşımlar bu çerçevede beklenen faydayı sağlamaz.