
Llms.txt tanımı ve kapsamı
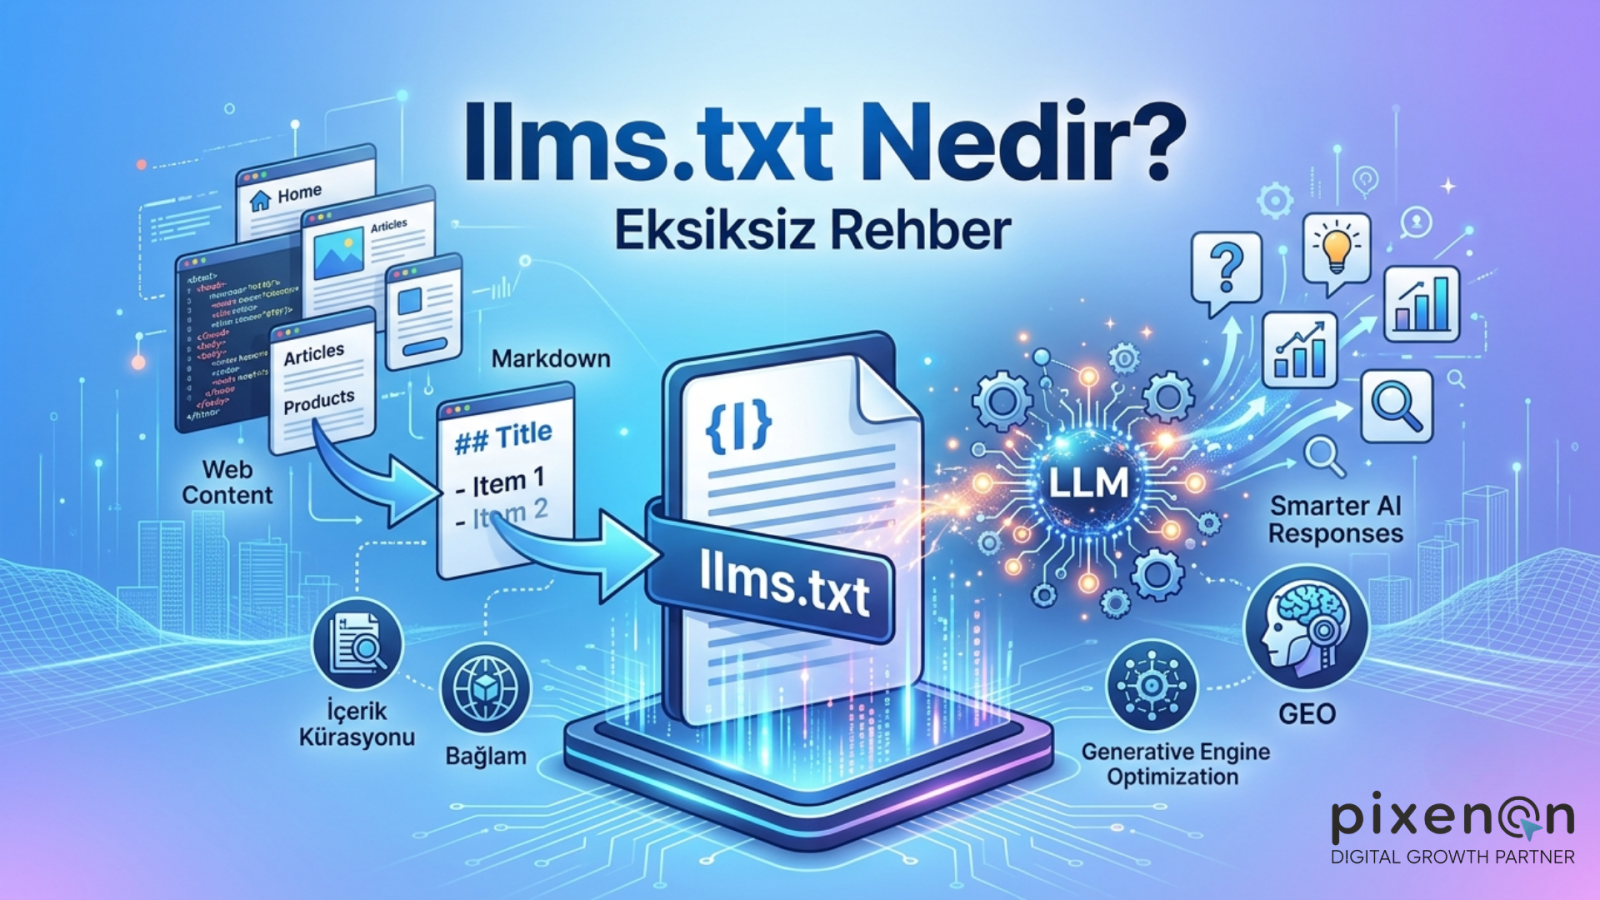
llms.txt nedir sorusunun kısa cevabı: web sitenizin kök dizinine eklenen, Markdown formatında yazılmış bir metin dosyasıdır. Amacı, ChatGPT, Claude, Gemini gibi büyük dil modellerine (LLM – Large Language Models) sitenizin en önemli içeriklerini açık, düzenli ve işlenebilir biçimde sunmaktır. Klasik HTML sayfasından farkı, insan ziyaretçiyi değil makineyi muhatap almasıdır. Öneriyi ilk kez Eylül 2024’te Jeremy Howard gündeme getirdi. Howard, Answer.AI ve fast.ai’nin kurucusu; önerisi kısa sürede teknik SEO topluluğunun gündemine girdi. Standart tanım ve biçim kuralları llmstxt.org adresinde yayımlanıyor.
llms.txt, bir dil modeline “sitemde şu sayfalar var, özetleri bunlar” diyen düz metin bir dizindir. HTML’in yerini almaz; tarayıcıya yardımcı bir katman olarak çalışır.
Şöyle düşünün: Bir insan sitenizi ziyaret ettiğinde tasarım, menü ve görseller yol gösterir. Bir dil modeli ise binlerce satır HTML, reklam script’leri, çerez kutucukları ve JavaScript ağırlığıyla boğuşur. Bu karmaşada hangi içeriğin gerçekten önemli olduğunu ayırmak zorlaşır. llms.txt tam bu noktada devreye girer.
Dosya Yapısı
Dosya kök dizinde, yani siteadi.com/llms.txt yolunda durur. İçeriği başlık, kısa açıklama ve bağlantı listesinden oluşur. Her satır tek bir kaynağı işaret eder; model dosyayı satır satır okuyabilir.
- H1 başlık: Projenin veya sitenin adı.
- Blockquote özet: Sitenin ne yaptığını anlatan bir-iki cümle.
- Bağlantı listesi: Sayfa adı, URL ve kısa açıklama.
- İsteğe bağlı bölümler: “Optional” başlığı altında ikincil kaynaklar.
Basit Bir Örnek
Aşağıdaki yapı, 40 sayfalık bir klinik sitesi için düşünülebilir. Amaç, modelin ana hizmet sayfalarını hızlıca bulmasını sağlamak.
| Alan | Örnek |
|---|---|
| Başlık | # Örnek Klinik |
| Özet | > Randevu ve hizmet bilgileri |
| Bağlantı | – [Randevu](https://ornek.com/randevu): Saatler ve iletişim |
| Optional | – [Blog](https://ornek.com/blog): Genel bilgi yazıları |
Bu tablo bir şablon niteliğinde; gerçek dosyada her satır Markdown bağlantısı olarak yazılır. Model, bağlantı adı ve açıklamasından sayfanın ne içerdiğini çıkarır.
Ne İşe Yarar, Ne Yapmaz?
llms.txt, modelin sitenizi daha az yanlış anlamasına yardımcı olabilir. Ancak bir sıralama garantisi vermez; arama motoru sonuçlarını doğrudan etkilediğine dair resmi bir kanıt yok. Google’ın tarama ve dizine ekleme kuralları Google Search Central üzerinden yürür; llms.txt bu kuralların yerine geçmez. Ölçüt basit: Dosya, modelin ana sayfaları bulmasını kolaylaştırıyorsa işe yarıyor demektir. Bunu, yapay zeka arayüzlerinde marka adı ve hizmet sorgularıyla yapılan manuel testlerle izleyebilirsiniz. Sonuçlar modele, tarihe ve sorguya göre değişir.
robots.txt ile Farkı Ne?
llms.txt Nedir sorusunun en çok karıştırıldığı yer burasıdır: robots.txt erişimi yönetir, llms.txt ise içeriği açıklar. İkisi aynı işi yapmaz, birbirinin yerine de geçmez. Aralarındaki temel farkı bilmek, dosyaları doğru konumlandırmanın ilk adımıdır. robots.txt, arama motoru botlarına “şu sayfaları tara, şunları tarama” diyen bir erişim kuralı dosyasıdır. Bir güvenlik kapısı gibi çalışır; botun hangi dizinlere girebileceğini söyler. Tarama davranışını sınırlar ya da serbest bırakır. llms.txt ise yapay zeka modellerine “işte sitem hakkında bilmen gerekenler ve en önemli sayfalarım” diyen bir içerik rehberidir. Tanıtım broşürü gibi düşünülebilir. Engelleme ya da izin direktifi içermez, yalnızca içeriği düzenli biçimde sunar. llms.txt hiçbir botu engellemez veya izin vermez; bu yüzden robots.txt ile çelişmesi diye bir durum ortaya çıkmaz. İki dosya farklı katmanlarda çalışır. sitemap.xml ile de karıştırmamak gerekir. sitemap.xml tüm sayfalarınızın listesini verir; llms.txt ise hangi sayfaların gerçekten önemli olduğunu ve neden önemli olduğunu anlatır. Sitemap bir envanter, llms.txt bir editöryal seçkidir.
Ölçüt Bazlı Karşılaştırma
| Ölçüt | robots.txt | llms.txt | sitemap.xml |
|---|---|---|---|
| Amaç | Erişim kontrolü | İçerik rehberliği | Sayfa envanteri |
| Hedef | Arama botları | Dil modelleri | Arama botları |
| İçerik | İzin/engel kuralları | Önemli sayfa özetleri | URL listesi |
| Engeller mi? | Evet | Hayır | Hayır |
Kısa Bir Senaryo
Diyelim ki 40 sayfalık bir klinik sitesi yönetiyorsunuz. robots.txt’te randevu formu ve yönetim paneli gibi tarama dışı kalması gereken yolları belirtirsiniz. sitemap.xml tüm sayfaları listeler. llms.txt’ye ise yalnızca hizmet sayfaları, hekim profilleri ve sık sorulan sorular gibi modellerin alıntılayabileceği bölümleri koyarsınız. Beklenen çıktı: botlar doğru sayfaları tarar, model tabanlı yanıtlar ise sizin seçtiğiniz içerikten beslenir. Adımlar sırayla şöyle işler:
- robots.txt ile taranmaması gereken yolları tanımla.
- sitemap.xml ile tüm sayfaları listele.
- llms.txt’ye yalnızca öne çıkarmak istediğin sayfaları ve kısa açıklamalarını ekle.
Bu üç dosya birbirini tamamlar; biri diğerinin yerine geçmez. Dosya yapısının standart tanımı için llmstxt.org ve tarama kuralları için Google Search Central belgelerine bakabilirsiniz.
llms.txt Nasıl Görünür? Dosya Yapısı ve Format
llms.txt standart bir Markdown dosyasıdır. Özel bir yazılım, eklenti ya da programlama bilgisi gerektirmez. Herhangi bir metin editörüyle yazılabilir. Dosyanın genel yapısı şu bölümlerden oluşur:
1. Başlık (H1): Sitenizin veya markanızın adı. 2. Açıklama Bloğu (> ile başlar): Sitenizi bir paragrafta tanıtan kısa bir özet. Yapay zeka modeli bu bloğu okuyarak sitenizin ne hakkında olduğunu hızlıca kavrar. 3. Bölümler (H2): İçeriklerinizi mantıklı kategorilere ayırın. Örneğin “Hizmetler”, “Blog”, “Dokümantasyon”, “Hakkımızda” gibi. 4. Bağlantılar (Liste formatında): Her bölüm altında, ilgili sayfaların URL’leri ve kısa açıklamaları. 5. Opsiyonel Bölüm: Daha az kritik ama yine de faydalı olabilecek içerikler için ayrı bir bölüm. Bir dijital büyüme ajansı için örnek llms.txt şöyle görünebilir:
llms.txt, büyük dil modellerine sitenizin yapısını ve öne çıkan içeriğini özetleyen, kök dizinde yayımlanan düz metin dosyası anlamına gelir. ChatGPT, Gemini ve Perplexity gibi sistemlerin sayfalarınızı daha az belirsizlikle okumasına yardımcı olur. Klasik SEO araçları Googlebot için yazılmıştı; bugün aynı içeriği yapay zeka sistemleri de işliyor. Bu dosya bir sıralama aracı değil, bağlam katmanıdır. Standart henüz resmi bir protokol değil, llmstxt.org üzerinden yürüyen bir öneri olarak tartışılıyor.
Llms.txt Nedir? neden önemlidir?
Llms.txt Nedir?, arama sonuçlarında ve yapay zekâ yanıtlarında aynı sayfanın farklı bağlamlarda okunması nedeniyle ayrıca ele alınması gereken bir başlıktır. Bu yazıda izlenen yaklaşım üç katmandan oluşur: tanımın netliği, verinin kaynağı ve başlık yapısının tutarlılığı. Google ve ChatGPT gibi sistemler bir sayfayı değerlendirirken bu katmanları birlikte okur; bu nedenle llms.txt Nedir? çalışmasında tek bir cümleye değil, sayfanın bütününe bakmak gerekir.
Llms.txt Nedir? çalışmasında hangi üç katman öne çıkar?
- Tanım katmanı: Konunun tek cümleyle ve tartışmasız biçimde tanımlanması.
- Veri katmanı: Kullanılan sayıların kaynağının ve ölçüm yönteminin belirtilmesi.
- Yapı katmanı: Başlıkların soru ve yanıt düzeninde ilerlemesi.
Llms.txt Nedir? nasıl ölçülür?
Ölçüm tek seferlik bir kontrol değil, düzenli aralıklarla yinelenen bir döngüdür. Aşağıdaki tablo, llms.txt Nedir? çalışmasında izlenebilecek dört adımı ve her adımın çıktısını özetler. Adımlar sırayla uygulandığında hangi değişikliğin hangi sonucu etkilediğini ayırt etmek kolaylaşır. Tablo, ölçümün kapsamını daraltmak için de kullanılabilir; böylece her turda aynı veri seti karşılaştırılır.
| Adım | Yapılan iş | Çıktı |
|---|---|---|
| 1 | Mevcut sayfaların tanım cümleleri taranır | Eksik tanım listesi |
| 2 | Başlık yapısı soru düzenine göre gözden geçirilir | Yeni başlık planı |
| 3 | Veri ve kaynak atıfları kontrol edilir | Kaynak tablosu |
| 4 | Sonuçlar aylık olarak karşılaştırılır | Değişim raporu |
Llms.txt Nedir? için hızlı kontrol listesi
Kontrol listesi 6 maddeden oluşur ve her madde tek başına yanıtlanabilir. Liste, llms.txt Nedir? çalışmasında hangi adımın tamamlandığını görmek için kullanılır; böylece aynı iş iki kez yapılmaz.
| Madde | Kontrol | Durum |
|---|---|---|
| 1 | İlk paragrafta tanım cümlesi var | Evet / Hayır |
| 2 | Başlıklar soru düzeninde ilerliyor | Evet / Hayır |
| 3 | Sayılar kaynağıyla veriliyor | Evet / Hayır |
| 4 | Dış başvurular listelenmiş | Evet / Hayır |
| 5 | İç bağlantılar kurulmuş | Evet / Hayır |
| 6 | Ölçüm düzeni tanımlanmış | Evet / Hayır |
Llms.txt Nedir? çalışmasında adım adım uygulama
Aşağıdaki altı adım, llms.txt Nedir? çalışmasını küçük ve izlenebilir parçalara ayırır. Her adım tek başına tamamlanabilir; böylece ekip hangi aşamada olduğunu net biçimde görür. Adımların sırası değişebilir, ancak tanım ve veri adımları tamamlanmadan yapı adımına geçmek ölçüm sonuçlarını belirsizleştirir.
- 1. adım, Konuyu tek cümleyle tanımla: Sayfanın ilk paragrafında konu, tartışmasız bir tanım cümlesiyle açıklanır.
- 2. adım, Başlıkları soruya çevir: Okuyucunun arama sırasında kurduğu soru, başlıkta aynı biçimde karşılanır.
- 3. adım, Veriyi kaynağıyla yaz: Metinde kullanılan her sayı, kimin hangi yöntemle ölçtüğü belirtilerek verilir.
- 4. adım, Dış başvuruları listele: Tanım ve yöntem için başvurulan belgeler yazının sonunda açıkça gösterilir.
- 5. adım, İç bağlantıları kur: Aynı konuyu işleyen sayfalar birbirine bağlanır, okuyucu tek yerde kalmaz.
- 6. adım, Ölçümü yinele: Aynı veri seti düzenli aralıklarla karşılaştırılır ve değişim not edilir.
Sıkça sorulan sorular
llms.txt nedir?
llms.txt, web sitesi kök dizinine eklenen Markdown formatında bir metin dosyasıdır. Amacı, ChatGPT, Claude, Gemini gibi büyük dil modellerine sitenin en önemli içeriklerini açık ve düzenli biçimde sunmaktır. Bu dosya, modellerin içeriği daha kolay bulmasına yardımcı olur.
llms.txt ile robots.txt arasındaki fark nedir?
robots.txt, arama motoru botlarına hangi sayfaların taranacağını söyleyen kurallar dosyasıdır. llms.txt ise dil modellerine sitenin önemli içeriklerini düzenli biçimde sunan bir içerik rehberidir. Yani biri erişim kurallarını, diğeri içeriğin işlenebilir sunumunu hedefler.
llms.txt dosyası nasıl hazırlanır?
llms.txt, sitenin kök dizinine Markdown formatında bir metin dosyası olarak eklenir. İçinde sitenin en önemli içerikleri açık ve düzenli bir yapıda listelenir. Dosya, dil modellerinin karmaşık HTML, reklam scriptleri ve JavaScript yükü arasında önemli içeriği bulmasını kolaylaştıracak şekilde kurgulanır.
llms.txt fikri kim tarafından ve ne zaman gündeme getirildi?
llms.txt fikri, Eylül 2024'te Answer.AI ve fast.ai'nin kurucusu Jeremy Howard tarafından gündeme getirildi. Öneri kısa sürede teknik SEO topluluğunun dikkatini çekti. Bu tarih, önerinin ilk kez kamuya açıklandığı zamanı gösterir.
Kaynaklar ve başvuru belgeleri
Aşağıdaki belgeler, bu yazıdaki tanımların ve ölçüm yaklaşımının arka planını oluşturur. Her bağlantı ilgili konunun resmî veya birincil dokümanına gider; llms.txt Nedir? çalışmasında başvuru kaynağı olarak kullanılabilir.
- Google Arama Merkezi: SEO başlangıç rehberi
- Schema.org: FAQPage yapılandırılmış veri tanımı
- W3C: WCAG 2.1 hızlı başvuru
- Google Destek: arama sonuçlarında görünme