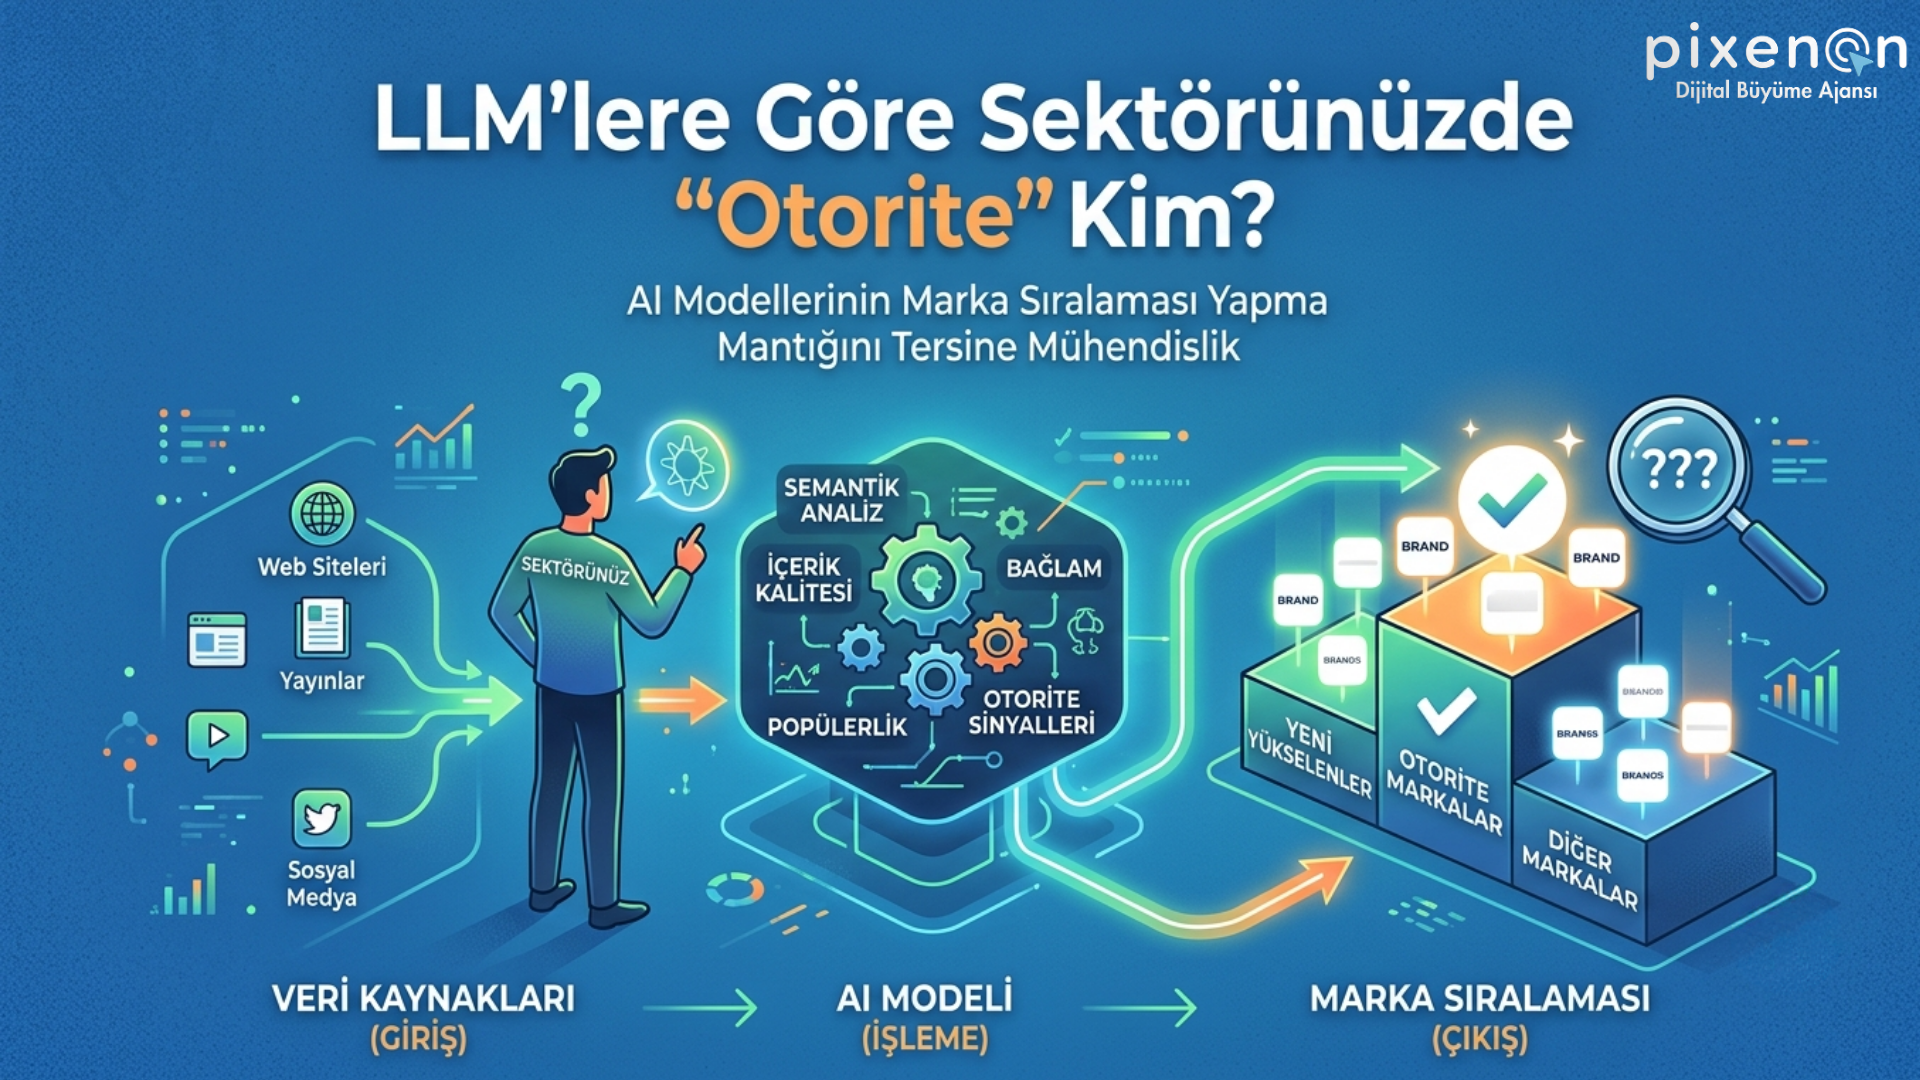
LLM’lere Göre Sektörünüzde “Otorite” Kim? AI Modellerinin Marka Sıralaması Yapma Mantığını Tersine Mühendislik
Pixenon Büyüme Ajansı
Bir kullanıcı Perplexity’ye “İzmir’deki en iyi büyüme ajansları kimler?” diye sorduğunda, model bir saniyeden kısa bir sürede birkaç marka adı üretiyor. Bu isimler nereden geliyor? Hangi mantıkla seçiliyor? Ve daha önemlisi: markanız bu listede neden yok ya da nasıl olabilir? Bu sorular, 2026’nın en kritik pazarlama sorularından biri haline geldi.
Pixenon büyüme ajansı olarak, kurucumuz Kenan Ayvataş’ın liderliğindeki AI görünürlük ekibimiz, bu soruyu “tersine mühendislik” perspektifinden ele alıyor: LLM’lerin kara kutusunu açamayız, ama dışarıdan gözlemleyerek, hangi sinyallerin “otorite” algısını güçlendirdiğini ve hangi davranışların görünürlüğü zayıflattığını net şekilde haritalayabiliriz.
Önemli Bir Netleştirme: LLM’ler “Sıralama” Yapmıyor
Başlamadan önce, dilin yarattığı bir kafa karışıklığını netleştirmek gerekiyor. LLM’ler, Google’ın anladığı anlamda bir “sıralama” yapmıyor. Ortada bir ters dizin (inverted index), bir PageRank veya deterministik bir sıralama mekanizması yok. “Sıralama faktörleri” dediğimizde, aslında kastettiğimiz şey “ilişkili görünürlük faktörleri” yani araştırmalarda yüksek atıf oranlarıyla birlikte gözlenen, kara kutudan tersine mühendislikle çıkardığımız nedensel bir mekanizma değil, korelasyon gösteren unsurlar.
Bu netleştirme önemli, çünkü “LLM algoritmasını kırdık” diyen her iddiaya şüpheyle yaklaşmak gerekiyor. Ama bu, hiçbir şey öğrenemeyeceğimiz anlamına gelmiyor. Aksine, çok sağlam araştırmalar ve büyük ölçekli sektör analizleri, hangi sinyallerin AI cevaplarında atıfta bulunulma olasılığıyla güçlü şekilde ilişkili olduğunu gösteriyor. Pixenon’da Kenan Ayvataş’ın bu konudaki ifadesiyle: “Biz kara kutuyu açmaya çalışmıyoruz; kara kutunun girdi-çıktı davranışını gözlemleyip, hangi girdilerin daha iyi çıktılar ürettiğini sistematik olarak test ediyoruz.”
LLM’ler Markaları “Entity” (Varlık) Olarak Görür
Geleneksel SEO’da bir web sitesi, bağlantılarla birbirine bağlı bir düğümdür. LLM’lerin dünyasında ise markanız bir “entity” yani bir varlık, bir kavram. LLM brand authority (LLM marka otoritesi), markanızın belirli anahtar kelimeler için sıralanmasından çok daha fazlasını kapsıyor: AI sistemlerinin markanızı sayısız senaryo ve kullanıcı niyeti boyunca nasıl anladığını, bağlamsallaştırdığını ve önerdiğini içeriyor.
AI sistemleri, markaları birden fazla sinyali eş zamanlı analiz eden sofistike sinir ağları aracılığıyla değerlendiriyor. Bu sinyaller arasında entity tanıma paternleri, atıf sıklıkları, bağlamsal ilgi ve otorite ilişkilendirmeleri bulunuyor. Yani model, “Pixenon” kelimesini gördüğünde, bunu sadece bir kelime dizisi olarak değil; “büyüme ajansı”, “İzmir”, “GEO/AEO”, “Kenan Ayvataş” gibi başka entity’lerle ilişkili bir kavram ağının parçası olarak işliyor.
Beş Temel Otorite Sütunu
LLM marka otoritesinin beş temel sütun üzerine kurulduğu söylenebilir. Bu sütunları tek tek ele alalım.
1. Entity Tanıma (Entity Recognition)
Bu, en temel sütun: AI sistemleri markanızı ne kadar açık şekilde tanımlıyor? Yapılandırılmış veri işaretlemesi (structured data markup), tutarlı NAP bilgisi (Name, Address, Phone isim, adres, telefon) ve açık entity tanımları, LLM’lerin markanızı doğru şekilde kategorize etmesine ve bağlamsallaştırmasına yardımcı oluyor. Markanız web’de iyi tanımlanmış bir entity olarak yer aldığında, AI modelleri ilgili sorgularda sizi daha yüksek güvenle önerebiliyor.
Pratik soru: bir AI modeli, “Pixenon ne yapar, kime hizmet verir, alternatiflerden nasıl farklılaşır?” sorusuna ne kadar net cevap verebilir? Bu netlik, web’deki dağınık bilgi parçalarının tutarlılığından geliyor.
2. Konuşma Dili Hizalanması (Conversational Language Alignment)
LLM’ler doğal dil üzerinde eğitiliyor ve cevapları konuşma paternlerinde üretiyor. İnsanların bir konuyu gerçekten nasıl konuştuğunu yansıtan içerik sorular, açıklamalar ve doğal dil akışı içeren, anahtar kelime istiflenmiş tanıtım metni değil LLM’lerin işleme ve öneri üretme biçimiyle çok daha iyi örtüşüyor.
Bu, “anahtar kelime optimizasyonu öldü” demek değil; ama “anahtar kelimeyi doğal bir cümleye nasıl yedirebilirim” sorusunun, “bu sayfaya kaç kez bu anahtar kelimeyi sığdırabilirim” sorusunun yerini aldığı anlamına geliyor.
3. Atıf Sıklığı ve Tutarlılık (Citation Frequency & Consistency)
Markanızın adı, web’de ne kadar sık ve ne kadar tutarlı şekilde geçiyor? Burada “tutarlılık” iki anlama geliyor: hem markanızın aynı isimle anılması (Pixenon, Pixenon Ajans, Pixenon Digital gibi varyasyonların aynı entity’ye bağlanabilmesi), hem de markanız hakkında söylenenlerin birbiriyle çelişmemesi.
4. Bağlamsal İlgi (Contextual Relevance)
Markanız hangi konularla birlikte anılıyor? Bir büyüme ajansı için “performans pazarlama”, “GEO”, “AEO”, “programatik SEO” gibi terimlerle tutarlı şekilde birlikte geçmek, modelin markanızı bu konuların bir “uzmanı” olarak kodlamasına yardımcı oluyor. Bu, anahtar kelime eşleşmesinden farklı bir şey bir kavramsal komşuluk inşa etmek.
5. Otorite İlişkilendirmeleri (Authority Associations)
Markanız, sektörünüzde tanınmış başka isimlerle, yayınlarla veya kurumlarla ilişkilendiriliyor mu? Bu, E-E-A-T çerçevesindeki “Authoritativeness” (Otorite) boyutuyla doğrudan örtüşüyor: saygın akranlar veya sektör uzmanları tarafından tanınma.
Bu beş sütunun bir araya gelişi, çarpıcı bir fark yaratıyor: güçlü LLM otoritesine sahip markaların, optimize edilmemiş görünürlüğe sahip markalara kıyasla AI tarafından üretilen önerilerde %340’a kadar daha fazla yer aldığı raporlanıyor. Bu rakam tek başına bir hedef olmamalı, ama yönü gösteriyor: bu beş sütunda sistematik çalışma, ölçülebilir bir fark yaratıyor.
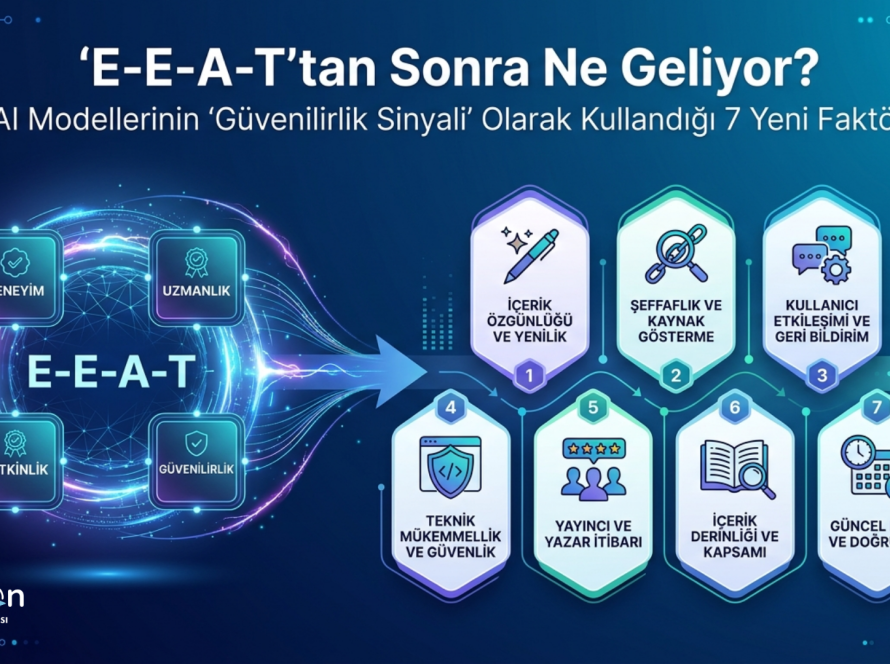
E-E-A-T Merceğinden Otorite Sinyalleri
LLM’lerin otorite değerlendirmesini anlamanın bir başka yolu, her potansiyel sinyali E-E-A-T (Experience, Expertise, Authoritativeness, Trustworthiness Deneyim, Uzmanlık, Otorite, Güvenilirlik) merceğinden geçirmek. Bu çerçeve, hem Google’ın hem de AI modellerinin güvenilirlik sinyallerini değerlendirme biçiminde ortak bir dil sağlıyor.
Deneyim (Experience): Kaynak, ilk elden bilgi gösteriyor mu? Gerçek bir ürün testi mi, yoksa bir özetin özeti mi? Bir markanın kendi deneyimlerinden, vaka çalışmalarından, somut sonuçlardan bahsetmesi, “ilk elden bilgi” sinyalini güçlendiriyor.
Uzmanlık (Expertise): Yazarın veya yayıncının doğrulanmış kimlik bilgileri var mı, özellikle “Your Money or Your Life” (YMYL — finans, sağlık, hukuk gibi yaşamı doğrudan etkileyen) konularda? Bir büyüme ajansı için bu, kurucu ve uzmanların adlarının, geçmişlerinin ve uzmanlık alanlarının web’de açık ve tutarlı şekilde belgelenmesi anlamına geliyor.
Otorite (Authoritativeness): Site, saygın akranlar veya sektör uzmanları tarafından tanınıyor mu? Sahte veya şişirilmiş kimlik bilgileri cezalara yol açabiliyor yani bu sinyalleri “yapay olarak” inşa etmeye çalışmak, hem Google hem AI modelleri için risk taşıyor.
Güvenilirlik (Trustworthiness): Kaynak şeffaf ve güvenilir mi? E-E-A-T doğrulanmış sitelerden gelen linkler, hem Google’a hem AI modellerine güvenilirliğinizi teyit eden güçlü dış sinyaller olarak işliyor.
Pixenon’da Kenan Ayvataş’ın yaklaşımı şu: “Her bir link veya atıf fırsatını E-E-A-T merceğinden geçiriyoruz. ‘Bu atıf, markamızın deneyimini, uzmanlığını, otoritesini veya güvenilirliğini gerçekten yansıtıyor mu’ sorusu, hangi fırsatları kovalayacağımızı belirliyor.”
“Consensus Vector” Stratejisi: “En İyi” Listelerinde Nasıl Yer Alınır?
2026’da B2B pazarlamasının en köklü taktiklerinden biri köklü bir değişime uğradı. On yıl boyunca, “en iyi yazılım” listicle’larında (liste makalelerinde) yüksek otoriteli bir yayıncının listesinde #1 sırada olmak, pazarın sahibi olmak anlamına geliyordu. 2026’da bu dinamik tersine döndü: alıcılar artık 3.000 kelimelik makaleleri kaydırmıyor; Perplexity’den, Gemini’den veya ChatGPT’den “kendi kullanım senaryom için en iyi 3 aracı karşılaştır” diye soruyorlar.
Bu kaymaya cevap olarak ortaya çıkan yaklaşım, “Consensus Vector” (Konsensüs Vektörü) olarak adlandırılıyor. Bu, dağıtık veri setleri arasında yorum siteleri, forumlar ve sahip olunan içerik marka algısını hizalayarak, AI tarafından üretilen “en iyi” listelerine dahil olmayı mühendislik eden bir GEO çerçevesi. Web’de tutarlı bir anlamsal patern oluşturarak, B2B markaları LLM’lerin, ürünlerini yüksek niyetli sorgulara mantıksal cevap olarak istatistiksel şekilde tahmin etmesini “zorlayabiliyor” odak, anahtar kelime sıralamalarından entity atıflarına kayıyor. LLM’ler, sonuçta birer tahmin makinesi.
Bu stratejinin pratik uygulaması üç kanaldan geçiyor:
Yapılandırılmış yorum platformları: G2, Capterra, TrustRadius gibi platformlar, RAG (retrieval-augmented generation) sistemlerinin kolayca ayrıştırdığı yapılandırılmış metin sağlıyor. Buradaki açıklamaların, hedeflediğiniz konumlandırmayla tam uyumlu olması gerekiyor.
Forumlar ve topluluklar (yapılandırılmamış/insan kaynaklı): Reddit ve Quora, Google Gemini ve SearchGPT gibi modeller tarafından “gerçek insan deneyimi” temsil ettikleri için ağır şekilde ağırlıklandırılıyor. Buralarda bir varlığa sahip olmak gerekiyor spam değil, ama markanızı belirli sorunları çözme bağlamında anan, gerçekten yardımcı cevaplar.
Sektörel otorite (editöryel): Yüksek domain otoritesine sahip yayınlardaki (sektörel bloglar, haber siteleri) atıflar, entity’nin önemini doğruluyor.
Buradaki temel ilke şu: LLM’ler, kendi pazarlama metninizden çok üçüncü taraf veriye güveniyor. Web’i, konumlandırmanızı doğrulayan atıflarla “ekmeniz” gerekiyor yani markanızın kendi sitesinde ne söylediğinden çok, başkalarının markanız hakkında ne söylediği önem taşıyor.
Entity Anchor: Tutarlı İsimlendirmenin Gücü
Bu stratejilerin hepsinin altında yatan teknik bir gereklilik var: entity anchor (varlık çapası). Markanızı, ürününüzü veya hizmetinizi tutarlı bir ifadeyle çapalamak örneğin sürekli “[X] için Büyüme Ajansı” gibi bir formülle anılmak AEO için en kritik adımlardan biri. Bu tutarlılık olmadan, web’deki farklı atıflar modelin gözünde farklı entity’ler gibi parçalanabilir; tutarlılık ile bu atıflar tek bir güçlü entity’ye birikir.
Yapılandırılmış Veri: Hızlı ve Ölçülebilir Bir Kaldıraç
Otorite sinyalleri arasında, en hızlı ve en ölçülebilir sonuç veren müdahale yapılandırılmış veridir (structured data). Akademik araştırmalar, atıflar, istatistikler ve açık entity işaretlemesi gibi yapılandırılmış bilgi sunumunun, test edilen tüm müdahaleler arasında en büyük görünürlük kazanımını sağladığını gösteriyor. Sektör analizleri, kapsamlı schema’ya sahip sayfalar için işaretlenmemiş kontrol gruplarına kıyasla %28-40 aralığında bir kapsama artışı (coverage lift) raporluyor ve bu çalışmalar arasında etki büyüklükleri yakınsıyor.
Hız açısından da fark var: yapılandırılmış veri iyileştirmeleri, 14-21 gün içinde %28-34’lük bir kapsama artışı gösterebiliyor; içerik güncellemelerinin kayda geçmesi ise tipik olarak 30-45 gün sürüyor. Bu, “hangi müdahaleyi önce yapmalıyım” sorusuna pratik bir cevap veriyor: schema ve entity işaretlemesi, görece düşük maliyetli ve hızlı geri dönüşlü bir başlangıç noktası.
Eski Bilgi Tuzağı: “Geçmişin Markası” Olarak Anılmak
Otorite tersine mühendisliğinde sıkça atlanan bir risk var: eğer web’de markanız hakkında eskiden ne yaptığınıza veya kime hizmet verdiğinize dair önemli miktarda içerik varsa, LLM’ler sizi eski kullanım senaryoları için önerebilir — ama şu anda en iyi olduğunuz güncel uygulamaları gözden kaçırabilir. Markanız AI aramalarından eksik kalıyorsa, eski içerik bunun bir nedeni olabilir.
Bu, düzenli bir “entity güncelleme” disiplinini gerekli kılıyor: markanızın hizmet alanı, uzmanlık odağı veya konumlandırması değiştiğinde, bu değişikliği yansıtmayan eski içeriklerin güncellenmesi veya kaldırılması, modelin “güncel siz” ile “eski siz” arasında kafa karışıklığı yaşamaması için kritik.
Klasik SEO’ya Aşırı Optimizasyon Tuzağı
Bir başka tersine mühendislik bulgusu: anahtar kelime istiflenmiş, belirli arama sorguları için optimize edilmiş ama gerçek derinlikten veya doğal dil akışından yoksun içerik, geleneksel aramada iyi sıralanabilir ama LLM önerilerinde zayıf performans gösterebilir. Doğal dil üzerinde eğitilmiş AI modelleri, kapsamlı/yardımcı içerik ile öncelikle arama algoritmaları için optimize edilmiş içerik arasındaki farkı özellikle iyi ayırt edebiliyor.
Bu, klasik SEO’nun değersiz olduğu anlamına gelmiyor marka araması, tazelik (freshness), konu otoritesi ve çoklu platform varlığı her zaman önemliydi ve önemli olmaya devam ediyor. Yeni olan şey, bu klasik sinyallerin yeniden ağırlıklandırılması ve entity netliği, çıkarılabilirlik (extractability), bir alma kısayolu (retrieval shortcut) olarak yapılandırılmış verinin öne çıkması.
Pixenon’un Tersine Mühendislik Metodolojisi
Pixenon büyüme ajansı olarak, müşterilerimizin “LLM’lere göre sektörde kim otorite” sorusuna cevap ararken izlediğimiz süreç şöyle işliyor: önce, hedef sorgularımızı (örneğin “İzmir’de en iyi büyüme ajansı”, “GEO uzmanı kim”) büyük AI platformlarında çalıştırıp, hangi markaların hangi bağlamlarda öne çıktığını gözlemliyoruz. Ardından, öne çıkan markaların web’deki ayak izini analiz ederek entity netliği, atıf tutarlılığı, bağlamsal komşuluk, yapılandırılmış veri kullanımı, E-E-A-T sinyalleri hangi unsurların ortak olduğunu çıkarıyoruz. Bu, “tersine mühendislik” dediğimiz kısım: kara kutuyu açmıyoruz, ama girdi-çıktı ilişkisinden bir patern çıkarıyoruz.
Son olarak, bu paternleri müşterimizin entity profiline uyguluyoruz: entity anchor’ları netleştiriyoruz, schema’yı güçlendiriyoruz, consensus vector kanallarında (yorum platformları, forumlar, sektörel yayınlar) tutarlı bir varlık inşa ediyoruz ve eski/güncel olmayan içerikleri güncelliyoruz. Kurucumuz Kenan Ayvataş’ın bu süreci özetleyişi: “Biz ‘AI bizi neden sevmiyor’ diye sormuyoruz. ‘AI’nın gözünde biz şu anda hangi entity’yiz, ve olmak istediğimiz entity ile arasındaki fark ne’ diye soruyoruz. Cevap genellikle, sandığınızdan daha somut ve düzeltilebilir.”
Otorite, Şimdi Bir Veri Mühendisliği Problemi
“Sektörünüzde otorite kim?” sorusunun cevabı, artık sadece bir marka algısı meselesi değil aynı zamanda bir veri mühendisliği problemi. LLM’ler, web’deki dağınık sinyalleri (entity tanıma, atıf sıklığı, bağlamsal komşuluk, yapılandırılmış veri, E-E-A-T) toplayıp, bunlardan bir “kim kimdir” haritası çıkarıyor. Bu haritada nerede olduğunuzu bilmek ve oraya nasıl taşınacağınızı planlamak artık rastgele bir PR çalışması değil, sistematik, ölçülebilir bir disiplin.
Pixenon büyüme ajansı olarak, markanızın LLM’lerin gözündeki mevcut “entity haritasını” çıkarmak, sektörünüzdeki gerçek otorite paternlerini analiz etmek ve bu paternlere göre somut, ölçülebilir bir AI görünürlük yol haritası kurmak için buradayız. Çünkü 2026’da soru artık “Google’da kaçıncı sıradayız” değil “AI bir tavsiye istendiğinde, sektörümüzün otoritesi olarak kimi gösteriyor, ve bu kişi neden biz değiliz” sorusu. Bu sorunun cevabını birlikte bulalım.