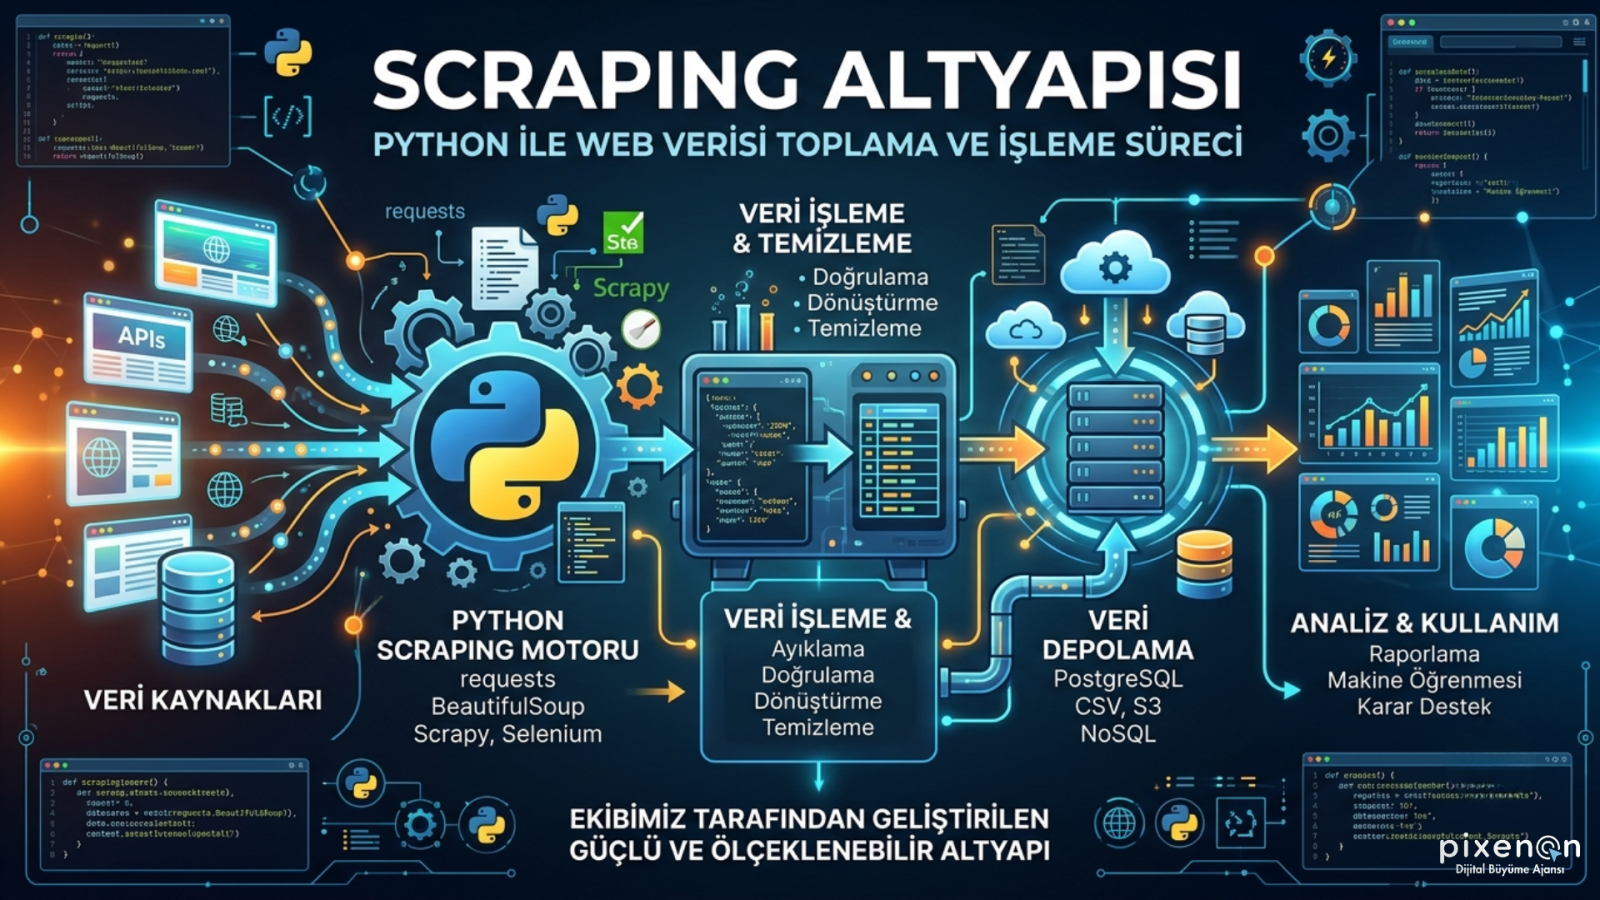
Programatik SEO projelerinde şablonların beslediği asıl yakıt veridir. Ekibimizin kurduğu Python scraping altyapısı, bu veriyi müşteri veritabanı ile açık web arasında köprüleyen bir üretim hattı gibi çalışıyor. Ham HTML’in toplandığı, temizlendiği ve yayına hazır hale getirildiği üç katmanlı bir akıştan söz ediyoruz. Yazının devamında bu hattın bileşenlerini, karar eşiklerini, uygulama adımlarını ve sınırlarını tek tek açıyorum.
Özet: Ekibimizin kurduğu Python scraping altyapısı üç katmandan oluşur. Toplama katmanı statik ve dinamik sayfaları ayırır, temizleme katmanı veriyi şemaya oturtur, depolama katmanı ise hedef sisteme yazar. Altyapının değeri hızdan çok, tekrarlanabilirlik ve denetlenebilirlikten gelir.
Python scraping altyapısı hangi problemi çözer
Hattı üç katmana ayırıyoruz: toplama, temizleme ve depolama. Her katman bir öncekinin çıktısını sözleşme gibi kabul eder. Bu ayrım, bir katmanda yapılan değişikliğin diğerlerini bozmasını önlüyor. Katmanlar arasındaki sözleşmeyi şema dosyasında tanımlıyoruz, böylece ekip içinde ortak bir referans kalıyor.
Toplama katmanında statik ve dinamik ayrımı
Statik HTML döndüren sayfalar için httpx ve BeautifulSoup ikilisini kullanıyoruz. httpx’i seçmemizin nedeni, aynı arayüzle hem senkron hem asenkron istek atılabilmesi. Uzun listeleri tararken asyncio ile paralel istek göndermek bekleme süresini kısaltıyor.
JavaScript ile render edilen sayfalarda Playwright devreye giriyor. Sayfanın ağ istekleri bitene kadar beklemek için networkidle koşulunu kullanıyoruz. Kritik içerik DOM’a erken yükleniyorsa domcontentloaded ile yetiniyoruz, bu da gereksiz beklemeyi kesiyor. Hangi koşulun kullanılacağını sayfa başına bir kez ölçüp yapılandırmaya yazıyoruz.
Uygulama adımı şöyle işliyor. Önce hedef URL listesinden küçük bir örneklem alıyoruz. Her URL için sunucunun döndürdüğü ham yanıtı inceliyoruz. Aranan alanlar ham HTML içinde görünüyorsa statik yol yeterli. Görünmüyorsa tarayıcı otomasyonu devreye giriyor. Bu ayrımı elle yapmak yerine otomatik bir kontrol fonksiyonuyla yapıyoruz.
Ölçüm kriteri, statik yoldan başarıyla ayrıştırılan sayfa oranı. Bu oran düştüğünde dinamik yolun payı artıyor, bu da çalışma süresini uzatıyor. Oranı izleyerek hangi hedef sitenin yapısının değiştiğini erken görüyoruz.
Temizleme katmanında şema disiplini
Ham HTML’den çekilen veri nadiren kullanıma hazır gelir. Fazla boşluklar, özel karakterler, tutarsız fiyat yazımları ve eksik alanlar sık karşılaşılan sorunlar. Türkçe karakter içeren eski sitelerde encoding hataları da tabloya ekleniyor. Bu sorunların her biri ayrı bir dönüştürme kuralı gerektiriyor.
Bu adımda Pydantic modelleri kullanıyoruz. Model hem doğrulama hem normalizasyon yapıyor. Fiyat alanı “1.200,50 TL” gibi gelirse ayıklanıp ondalık sayıya çevriliyor. Zorunlu alanı boş gelen kayıt ise hattın dışına alınıyor. Model tanımı tek yerde durduğu için kural değişikliği tüm ayrıştırıcılara aynı anda yansıyor.
Uygulama adımı olarak önce ham veriden örnek bir kayıt alıyoruz. Alanların gerçekte hangi biçimde geldiğini yazıyoruz. Sonra her alan için dönüştürme kuralını tanımlıyoruz. Fiyat, tarih ve sayı alanlarında biçim farkları en çok burada çıkıyor. Son olarak reddedilen kayıtların neden reddedildiğini etiketliyoruz.
Ölçüm kriteri, ayrıştırma hatası oranı. Bu oran yükseldiğinde ya hedef site biçim değiştirmiş ya da yeni bir uç durum ortaya çıkmış oluyor. Hata etiketlerini haftalık gözden geçirmek, hangi kuralın güncellenmesi gerektiğini gösteriyor.
Depolama katmanında hedefe göre seçim
Küçük ve orta ölçekli projelerde içerik şablonu Google Sheets üzerinden besleniyorsa scraper doğrudan oraya yazıyor. gspread ve servis hesabı kimliği bu iş için yeterli oluyor. Büyük hacimlerde PostgreSQL veya Supabase tercih ediyoruz, ORM katmanını SQLAlchemy ile kuruyoruz.
Müşteri ekibinin veriyi kendi görmesi veya düzeltmesi gereken projelerde Airtable devreye giriyor. Hangi hedefin seçileceği veri hacmine ve düzenleme ihtiyacına bağlı. Karar tablosunu yazının ilerleyen bölümünde paylaşıyorum.
Uygulama adımı olarak önce yazma işlemini tek bir toplu çağrıda mı, parça parça mı yapacağımızı belirliyoruz. Parça boyutu hedef sistemin kabul ettiği sınıra göre seçiliyor. Her parça yazımından sonra bir kontrol sorgusu çalıştırıyoruz. Yazılan satır sayısı beklenenle uyuşmuyorsa işlem geri alınıyor.
Ölçüm kriteri, yazma sonrası doğrulama sorgusunun tutarlılığı. Kayıt sayısı, tekil anahtar sayısı ve zorunlu alan doluluğu birlikte kontrol ediliyor. Bu üç değer tutarlıysa depolama adımı tamamlanmış sayılıyor.
Python tercihinin arkasındaki teknik gerekçeler
Scraping için Node.js tabanlı Playwright veya Puppeteer gibi güçlü alternatifler var. Ekibimizin kurduğu Python scraping altyapısında Python’ı seçmemiz dil tercihinden çok, iş akışının tek yerde bitmesiyle ilgili. Aşağıda bu tercihin somut gerekçelerini ve pratikte nasıl karşılık bulduğunu açıyorum.
Kütüphane olgunluğu
requests, httpx, BeautifulSoup, Playwright ve Selenium Python tarafında uzun süredir kullanılan araçlar. Aynı dil içinde istek atma, ayrıştırma ve tarayıcı otomasyonu yapılabiliyor. Bu da ekip içinde araç değiştirme maliyetini düşürüyor.
Topluluk desteği de önemli bir eşik. Bir hata mesajının çözümünü ararken karşılaştığımız örneklerin çoğu Python ekosisteminde mevcut oluyor. Bu, bakım süresini kısaltan pratik bir avantaj. Aynı avantaj, yeni bir kütüphaneyi denemek istediğimizde de geçerli.
Uygulama adımı olarak yeni bir hedef siteye başlarken önce en küçük çalışan örneği kuruyoruz. Tek bir URL, tek bir alan, tek bir çıktı. Bu örnek çalıştıktan sonra alan sayısını artırıyoruz. Böylece sorunun kütüphaneden mi yoksa sayfa yapısından mı geldiğini ayırmak kolaylaşıyor.
Ölçüm kriteri, bir ayrıştırıcının ilk çalışan sürüme ulaşma süresi. Bu süre uzadığında genellikle hedef sayfanın yapısı beklediğimizden karmaşık oluyor. Süreyi kaydetmek, hangi hedeflerin daha fazla mühendislik istediğini gösteriyor.
Veri işleme ile doğal bütünlük
Scraping sonrası temizleme, normalizasyon ve yükleme adımları ayrı bir dünyada yaşamıyor. Pandas, SQLAlchemy ve Pydantic aynı betik içinde çağrılabiliyor. Üç adımı tek dilde halletmek, ara format dosyalarına olan ihtiyacı azaltıyor.
Bu bütünlük hata ayıklamada da işe yarıyor. Bir kayıt neden reddedildi sorusunun yanıtı, aynı kod tabanındaki log satırlarında duruyor. Ayrı servisler arasında iz sürmek gerekmiyor. Aynı betik hem toplama hem doğrulama hem yazma adımını kapsadığında, tek bir çalıştırma kimliğiyle tüm iz sürülebiliyor.
Uygulama adımı olarak her çalıştırmaya bir kimlik veriyoruz. Bu kimlik toplama, temizleme ve yazma loglarının hepsine ekleniyor. Bir sorun çıktığında kimliği aratarak o çalıştırmadaki tüm adımları sırayla görebiliyoruz.
Ölçüm kriteri, bir hatanın kaynağına ulaşma süresi. Kimlik tabanlı iz sürme bu süreyi kısaltıyor. Süre uzadığında log alanlarının eksik kaldığı anlaşılıyor ve log şeması güncelleniyor.
Ekip içi ortak dil
Veri, SEO ve backend ekipleri aynı dili konuştuğunda devir teslim sürtünmesi azalıyor. Bir ayrıştırıcı fonksiyonu SEO ekibinden biri okuyup ne yaptığını anlayabiliyor. Bu, küçük ekiplerde belirgin bir fark yaratıyor.
Yeni ekip üyelerinin hatta katılma süresi de kısalıyor. Ortak dil, kod incelemesini ve kariyer görüşmelerindeki teknik değerlendirmeyi aynı zemine oturtuyor. Ayrıştırıcı kodu okumak, adayın veri akışını ne kadar anladığını göstermesi açısından pratik bir ölçüt oluyor.
Uygulama adımı olarak kod incelemesinde iki şeye bakıyoruz. Ayrıştırıcı hedef sayfanın hangi bölümünü hedefliyor, ve bu hedef değiştiğinde hangi test kırılacak. Bu iki soruya yanıt verilemiyorsa kod yeniden yazılıyor.
Ölçüm kriteri, kod incelemesinde geri dönen değişiklik oranı. Bu oran düşükse ekip aynı zemin üzerinde konuşuyor demektir. Oran yükseldiğinde ortak bir stil rehberi veya şablon dosyası eklemek gerekiyor.
Rate limiting ve etik scraping eşikleri
Bir siteyi aşırı yüklemek hem etik değil hem de IP engeli riskini beraberinde getiriyor. Hattımızda istek aralıkları, eşzamanlılık sınırı ve geri çekilme politikası birlikte çalışıyor. Bu üçlü, hem hedef siteyi hem kendi altyapımızı koruyor.
İstek aralığı ve eşzamanlılık
Her hedef alan adı için ayrı bir istek bütçesi tanımlıyoruz. Aynı anda açılan bağlantı sayısı sınırlı tutuluyor. Sunucu yavaşladığında eşzamanlılık otomatik düşüyor, böylece hattın kendisi yükün kaynağı olmuyor.
Yanıt kodları bu kararda belirleyici. Art arda gelen 429 veya 503 yanıtları hattı beklemeye alıyor. Bekleme süresi her tekrarda artıyor, sabit bir döngüye girmiyor. Bu artışın üst sınırı var; sınıra ulaşıldığında hat durup uyarı üretiyor.
Uygulama adımı olarak önce hedefin normal yanıt süresini ölçüyoruz. Sonra bu sürenin üstüne çıkan istekleri yavaşlatıyoruz. İstek bütçesini yapılandırma dosyasında tutuyoruz, kod içine gömmüyoruz. Böylece aynı hedef için farklı projelerde farklı bütçe kullanabiliyoruz.
Ölçüm kriteri, hız sınırı yanıtlarının toplam isteklere oranı. Bu oran yükseldiğinde istek bütçesi fazla açılmış oluyor. Oranı düşük tutmak, uzun vadede hattın kesintisiz çalışmasını sağlıyor.
robots.txt ve kullanım koşulları
Hedef sitenin robots.txt dosyası ilk kontrol noktası. İzin verilmeyen yollar taranmıyor. Kullanım koşullarında otomatik erişim yasağı varsa proje kapsamı yeniden değerlendiriliyor. Bu kontrolü teknik bir detay değil, proje kabul şartı olarak görüyoruz.
Google’ın resmi rehberleri de tırmama davranışı konusunda net sınırlar çiziyor. Google crawler dokümantasyonu bu sınırları anlamak için başlangıç noktası olabilir. Kişisel veri içeren sayfalarda ise tarama tamamen duruyor.
Uygulama adımı olarak her yeni hedef için bir kontrol listesi dolduruyoruz. robots.txt okundu mu, kullanım koşullarında otomatik erişim yasağı var mı, kişisel veri içeren sayfa var mı. Bu üç sorudan biri olumsuzsa hat kurulmuyor. Kontrol listesi proje dosyasında saklanıyor.
Ölçüm kriteri, kontrol listesi tamamlanmadan çalıştırılan hat sayısı. Bu sayının sıfır olması gerekiyor. Sıfırdan farklı bir değer görülürse süreçte bir atlama var demektir.
Kimlik ve iletişim bilgisi
User-Agent başlığında bot kimliğimiz ve iletişim adresi yer alıyor. Site yöneticisi trafikte kimin olduğunu görebiliyor. Bu şeffaflık, olası bir itirazda diyaloğu kolaylaştırıyor.
Toplanan verinin saklama süresi de proje sözleşmesinde yazılı oluyor. İş bitiminde geçici kopyalar siliniyor. KVKK metni bu noktada referans aldığımız temel düzenleme.
Uygulama adımı olarak saklama süresini yapılandırmaya yazıyoruz. Süre dolduğunda geçici tabloları temizleyen bir görev çalışıyor. Bu görevin çalıştığına dair log kaydı tutuluyor, böylece silme işlemi denetlenebilir kalıyor.
Ölçüm kriteri, saklama süresi dolmuş kayıtların geçici tablolarda kalma durumu. Bu kontrol düzenli yapıldığında veri hijyeni korunuyor. Aksi halde tablolar şişiyor ve sorgular yavaşlıyor.
Hangi hedefe hangi depolama yaklaşımı uygun?
Depolama seçimi projenin hacmine, düzenleme ihtiyacına ve yayın motoruna göre değişiyor. Aşağıdaki tablo nitel bir karşılaştırma sunuyor, sayısal eşik vermiyor. Nihai karar proje sahibiyle birlikte veriliyor.
| Hedef | Uygun olduğu durum | Dikkat edilecek nokta |
|---|---|---|
| Google Sheets | Şablon motoru tablo üzerinden besleniyor, ekip elle düzeltme yapıyor | Satır sayısı arttıkça okuma süresi uzar, eşzamanlı yazma çakışabilir |
| PostgreSQL | Kayıt hacmi büyük, ilişkisel sorgu ve geçmiş takibi gerekiyor | Şema değişikliği için migration disiplini şart |
| Supabase | Headless CMS mimarisi var, REST üzerinden okuma yeterli | Yetki anahtarlarının kapsamı dar tutulmalı |
| Airtable | Müşteri ekibi veriyi kendi görüp düzenleyecek | API hız sınırları toplu yazmada planlama gerektirir |
Yayın motoruyla uyum
Hedef sistemin neyi nasıl okuduğu, depolama kararını doğrudan etkiliyor. Webflow veya WordPress gibi motorlar tablo tabanlı beslemeyle iyi çalışıyor. Özel CMS’lerde ise doğrudan veritabanı yazımı daha temiz sonuç veriyor.
Şablon alanlarıyla veri alanlarının birebir eşleşmesi gerekiyor. Bir alan adı değiştiğinde hattın da güncellenmesi lazım. Bu eşleştirmeyi ayrı bir yapılandırma dosyasında tutuyoruz. Eşleştirme dosyası, şablon tarafındaki değişiklikleri tek yerden takip etmeyi sağlıyor.
Uygulama adımı olarak yayın motorunda tek bir test sayfası oluşturuyoruz. Bu sayfa hattın çıktısıyla besleniyor. Sayfa beklenen alanları gösteriyorsa eşleştirme doğru demektir. Sonra toplu üretime geçiyoruz.
Ölçüm kriteri, boş değişkenli üretilen sayfa sayısı. Bu sayı sıfır olmalı. Sıfırdan farklıysa eşleştirme dosyası ile şablon arasında bir kopukluk var.
Geçmiş ve geri alma ihtiyacı
Toplu üretimde hatalı bir kayıt binlerce sayfaya yayılabilir. Bu yüzden her yazma işlemi öncesi sürüm etiketi tutuyoruz. Geri alma gerektiğinde önceki etikete dönmek yeterli oluyor. Etiketler tarih ve çalıştırma kimliğiyle birlikte saklanıyor.
Değişiklik günlüğü, hangi kaydın hangi taramada geldiğini gösteriyor. Bu iz, hem hata ayıklamada hem de müşteriye raporlamada işe yarıyor. Aynı iz, hangi kaydın hangi şablon sürümüyle üretildiğini de gösteriyor.
Uygulama adımı olarak her toplu yazma öncesi bir etiket oluşturuyoruz. Etiket, o anki tablo durumunun kopyasını işaret ediyor. Hatalı bir üretim fark edildiğinde önceki etikete dönüp sorunlu çalıştırmayı yeniden kurguluyoruz.
Ölçüm kriteri, geri alma işleminin tamamlanma süresi. Bu süre kısa tutulmalı. Uzadığında etiketleme düzeninde bir sorun olduğu anlaşılıyor ve düzeltiliyor.
İçerik hattına bağlanma ve otomasyon
Scraping hattının çıktısı tek başına bir tablo değil, içerik üretiminin girdisi. Temizlenmiş veri şablon motoruna aktarıldığında sayfalar toplu halde oluşuyor. Bu bağlantıyı yapay zeka içerik otomasyonu tarafında kurduğumuz akışlarla birlikte yürütüyoruz.
Şablon motoruna aktarım
Aktarım adımında veri alanları şablon değişkenlerine bağlanıyor. Boş kalan değişken varsa sayfa üretilmiyor. Bu kural, ince içerikli sayfaların toplu halde yayına çıkmasını engelliyor. Kural, aktarım betiğinin ilk satırında kontrol ediliyor.
Üretim öncesi örneklem kontrolü yapıyoruz. Rastgele seçilen sayfalar elle okunuyor. Şablon cümlesi ile veri uyuşmuyorsa hat durduruluyor. Örneklem büyüklüğünü toplu üretimin boyutuna göre ayarlıyoruz.
Uygulama adımı olarak önce tek bir kategori için sayfa üretiyoruz. Bu sayfayı hem gözle hem de yapılandırılmış veri kontrolüyle inceliyoruz. Sonuç temizse kategori sayısını kademeli artırıyoruz. Her kademede aynı kontrol tekrarlanıyor.
Ölçüm kriteri, örneklem kontrolünde düzeltme gerektiren sayfa oranı. Bu oran yükseldiğinde şablon veya veri tarafına dönüyoruz. Oranı düşük tutmak, toplu üretimin kalitesini koruyor.
Yenileme döngüsü
Fiyat ve stok gibi alanlar zamanla değişiyor. Hattı belirli aralıklarla yeniden çalıştırıyoruz. Hangi alanın ne sıklıkla yenileneceği, alanın değişim hızına göre belirleniyor. Değişim hızını ölçmek için önce kısa bir gözlem dönemi yapıyoruz.
Yenileme sırasında yalnızca değişen kayıtlar güncelleniyor. Tüm tabloyu baştan yazmak hem gereksiz yük hem de geri alma riski demek. Fark tabanlı güncelleme bu riski azaltıyor. Fark hesabı için her kaydın önceki sürümünü saklıyoruz.
Uygulama adımı olarak yenileme çalıştırmasında önce mevcut kayıtları okuyoruz. Yeni taramadan gelen kayıtlarla karşılaştırıyoruz. Değişen alanları işaretleyip yalnızca onları yazıyoruz. Değişmeyen kayıtlar için yazma işlemi yapılmıyor.
Ölçüm kriteri, yenileme çalıştırmasında yazılan kayıt sayısının toplam kayıt sayısına oranı. Bu oran beklenenden yüksekse fark hesabı çalışmıyor demektir. Düşükse yenileme sıklığı fazla olabilir.
MCP ve erişilebilirlik tarafı
Üretilen sayfaların makine tarafından okunabilir olması ayrı bir başlık. Yapılandırılmış veri ve site haritası düzeni burada devreye giriyor. schema.org sözlüğü alan adlarını netleştirmek için başvurduğumuz kaynak.
Bu katmanı MCP entegras
Pixenon’dan ilgili sayfalar
Yaklaşımların karşılaştırması
| Yaklaşım | Ne zaman seçilir | Sınırı |
|---|---|---|
| Tarayıcı otomasyonu ile HTML ayrıştırmayı birleştiren kendi hattımız | Müşteri veri tabanıyla birleşen, şablon motoruna besleme yapılan ve tekrarlanabilirlik ile denetlenebilirliğin öne çıktığı pSEO projelerinde | Hazır servislere göre kurulum ve bakım yükü ekip üzerinde kalır; ayrıştırıcı ve şablon tarafının sürekli izlenmesini gerektirir |
| Hazır scraping servisleri (Apify, Scrapy Cloud, Bright Data gibi) | Belirli ve sınırlı işlerde, müşteri veri tabanıyla derin entegrasyon gerekmeyen toplama görevlerinde | Şablon motoru ve müşteri verisiyle birleşen akışta yeterli esnekliği sunmayabilir |
| Statik ve dinamik sayfaları ayıran toplama katmanı | Kaynak sitenin JavaScript ile render edilip edilmediği proje bazında değiştiğinde, ayrı proje açmadan tek hatta ilerlemek istendiğinde | Her iki modu birlikte taşıdığı için hat daha karmaşık hale gelir ve katman bazlı izleme şart olur |
Pixenon’dan ilgili sayfalar
Ekibimizin Kurduğu Python neden önemlidir?
Ekibimizin Kurduğu Python, arama sonuçlarında ve yapay zekâ yanıtlarında aynı sayfanın farklı bağlamlarda okunması nedeniyle ayrıca ele alınması gereken bir başlıktır. Bu yazıda izlenen yaklaşım üç katmandan oluşur: tanımın netliği, verinin kaynağı ve başlık yapısının tutarlılığı. Google ve ChatGPT gibi sistemler bir sayfayı değerlendirirken bu katmanları birlikte okur; bu nedenle Ekibimizin Kurduğu Python çalışmasında tek bir cümleye değil, sayfanın bütününe bakmak gerekir.
Ekibimizin Kurduğu Python çalışmasında hangi üç katman öne çıkar?
- Tanım katmanı: Konunun tek cümleyle ve tartışmasız biçimde tanımlanması.
- Veri katmanı: Kullanılan sayıların kaynağının ve ölçüm yönteminin belirtilmesi.
- Yapı katmanı: Başlıkların soru ve yanıt düzeninde ilerlemesi.
Ekibimizin Kurduğu Python nasıl ölçülür?
Ölçüm tek seferlik bir kontrol değil, düzenli aralıklarla yinelenen bir döngüdür. Aşağıdaki tablo, Ekibimizin Kurduğu Python çalışmasında izlenebilecek dört adımı ve her adımın çıktısını özetler. Adımlar sırayla uygulandığında hangi değişikliğin hangi sonucu etkilediğini ayırt etmek kolaylaşır. Tablo, ölçümün kapsamını daraltmak için de kullanılabilir; böylece her turda aynı veri seti karşılaştırılır.
| Adım | Yapılan iş | Çıktı |
|---|---|---|
| 1 | Mevcut sayfaların tanım cümleleri taranır | Eksik tanım listesi |
| 2 | Başlık yapısı soru düzenine göre gözden geçirilir | Yeni başlık planı |
| 3 | Veri ve kaynak atıfları kontrol edilir | Kaynak tablosu |
| 4 | Sonuçlar aylık olarak karşılaştırılır | Değişim raporu |
lı bir altyapı kuruyoruz.
Ekibimizin Kurduğu Python için hızlı kontrol listesi
Kontrol listesi 6 maddeden oluşur ve her madde tek başına yanıtlanabilir. Liste, Ekibimizin Kurduğu Python çalışmasında hangi adımın tamamlandığını görmek için kullanılır; böylece aynı iş iki kez yapılmaz.
| Madde | Kontrol | Durum |
|---|---|---|
| 1 | İlk paragrafta tanım cümlesi var | Evet / Hayır |
| 2 | Başlıklar soru düzeninde ilerliyor | Evet / Hayır |
| 3 | Sayılar kaynağıyla veriliyor | Evet / Hayır |
| 4 | Dış başvurular listelenmiş | Evet / Hayır |
| 5 | İç bağlantılar kurulmuş | Evet / Hayır |
| 6 | Ölçüm düzeni tanımlanmış | Evet / Hayır |
Ekibimizin Kurduğu Python için örnek akış
Bir sayfanın mevcut hâli ile düzenlenmiş hâli arasındaki fark, çoğu zaman üç küçük değişiklikten oluşur. İlk olarak giriş paragrafına tek cümlelik bir tanım eklenir. İkinci olarak uzun başlıklar soru biçimine çevrilir. Üçüncü olarak metindeki sayılar, kimin hangi yöntemle ölçtüğü belirtilerek yeniden yazılır. Bu üç değişiklik, sayfanın hem arama sonuçlarında hem de yapay zekâ yanıtlarında daha net okunmasını sağlar.
Düzenleme sonrası aynı sorular yeniden sorulur ve yanıtların kısaldığı görülür. Ekibimizin Kurduğu Python çalışmasında bu kontrol, her turun sonunda tekrarlanır. Amaç sayfa sayısını artırmak değil, var olan sayfaların anlaşılırlığını yükseltmektir.
Sık sorulan sorular
Programatik SEO (pSEO) nedir?
Programatik SEO, binlerce sayfayı manuel yazmak yerine veri ve şablonlarla otomatik üretme yöntemidir.
Bu yöntemin can damarı doğru ve güncel veridir.
pSEO projelerinde veri hangi kaynaklardan alınır?
Pixenon olarak pSEO projelerinde içerik şablonlarını besleyen veriyi çoğunlukla iki kaynaktan alıyoruz: müşterinin kendi veri tabanı ve açık web. Açık web verisine ulaşmak için Python tabanlı bir scraping altyapısı kuruyoruz.
Scraping için neden Python tercih ediliyor?
Python, requests, httpx, BeautifulSoup ve Playwright gibi araçlarla zengin bir ekosistem sunar. Bu nedenle Apify, Scrapy Cloud, Bright Data gibi hazır platformlar veya Node.js tabanlı Playwright/Puppeteer alternatifleri yerine Python’ı seçiyoruz.
Python scraping altyapısı ile hazır scraping platformları arasındaki fark nedir?
Hazır platformlar (Apify, Scrapy Cloud, Bright Data gibi) kullanıma hazır çözümler sunarken, Python tabanlı altyapı zengin ekosistemi sayesinde ihtiyaca göre özelleştirilebilir. Biz pSEO projelerimizde açık web verisine ulaşmak için Python tabanlı bir altyapı kuruyoruz.
Ekibimizin kurduğu Python scraping altyapısı, programatik SEO projelerinde şablonları besleyen veriyi müşteri veritabanı ile açık web arasında köprüleyen üç katmanlı bir üretim hattı demektir. Ham HTML’in toplandığı, temizlendiği ve yayına hazır hale getirildiği bu akışta ChatGPT, Gemini, Perplexity ve Google AI gibi araçların ürettiği içeriklerin doğrulanması da gündeme gelir. Altyapının değeri hızdan çok tekrarlanabilirlik ve denetlenebilirlikten gelir; zorunlu alanlar eksikse kayıt karantinaya düşer.