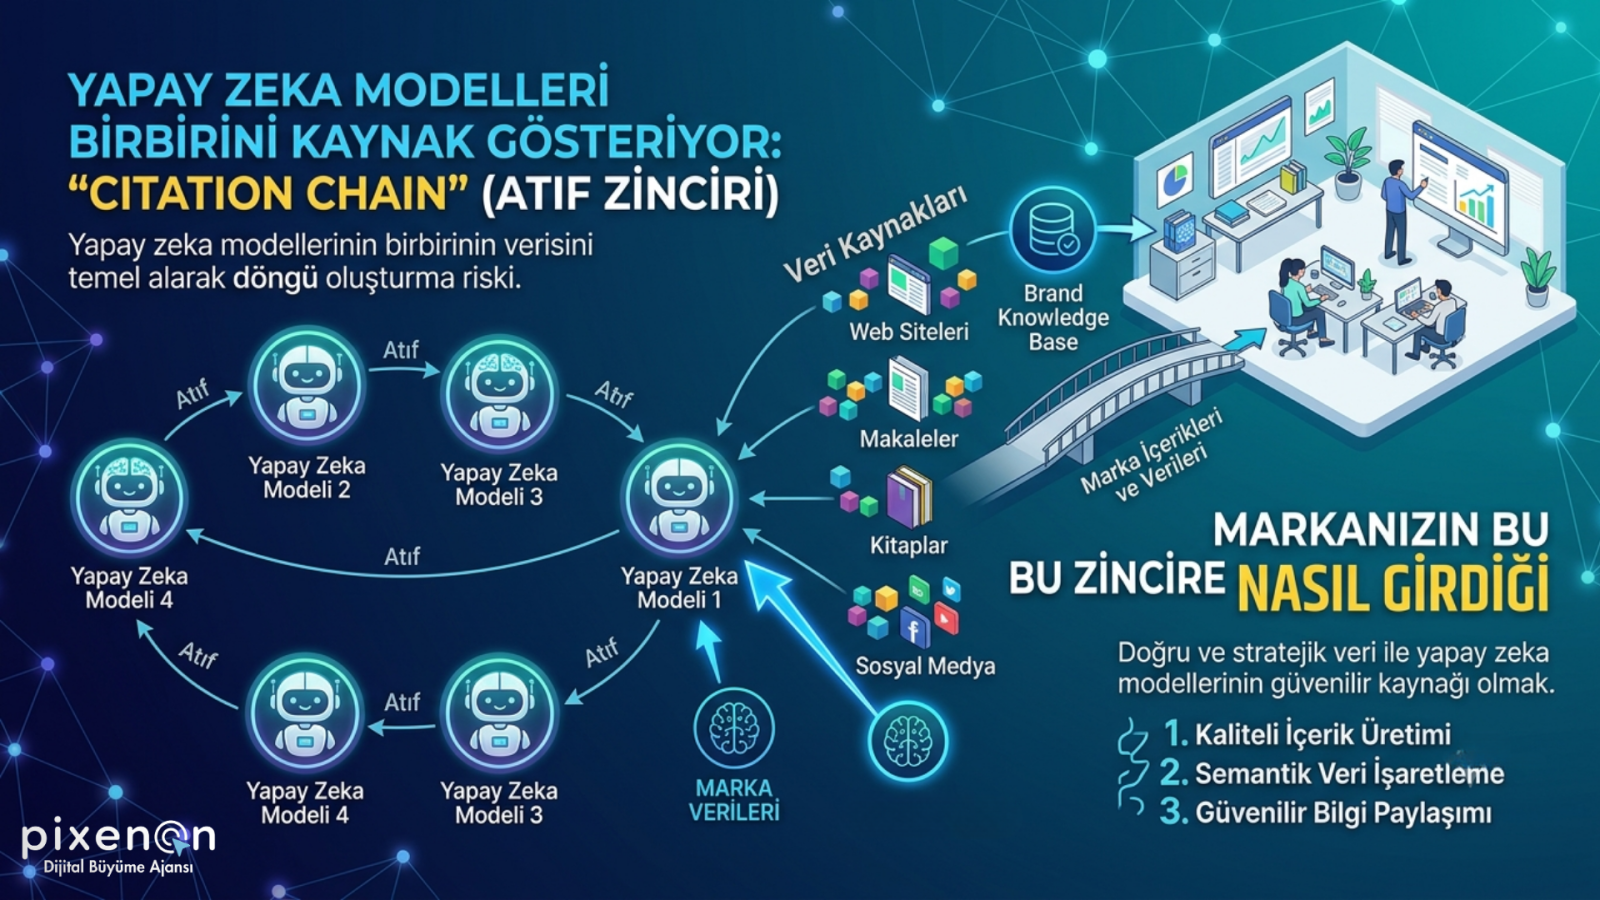
AI Modelleri birbirini kaynak gösterdiğinde ortaya çıkan tablo, tek başına güvenilirlik kanıtı değildir; aynı metnin birden fazla modelde görünmesi, bilginin bağımsız olarak doğrulandığı anlamına gelmez. Bir modelin çıktısını diğerinin alıntılaması, kaynak zincirini uzatır ama köküne yeni bir kanıt eklemez. Bu yüzden “üç model de aynı şeyi söylüyor” cümlesi, üç ayrı doğrulama gibi okunmamalı.
Mekanizma sade bir döngüye benziyor: bir modelin ürettiği metin web’e düşüyor, başka bir model onu eğitim verisinde ya da arama sonucunda buluyor, kendi yanıtına taşıyor. Zincir büyüdükçe kaynağın kendisi görünmezleşiyor. Sonuç, tek bir hatanın farklı üsluplarla çoğalması olabiliyor.
Bu giriş, döngünün nasıl kurulduğunu, hangi durumlarda zararsız kaldığını ve kaynak takibini ne zaman anlamlı hale geldiğini ele alıyor. Ardından doğrulama adımlarını ve ölçüm yöntemini örnek bir senaryo üzerinden sıralıyorum.
Yapay zeka arama sonuçları birbirini kaynak gösterdiğinde bilgi tek kaynağa döner ve doğrulama zorlaşır. Bu rehber, atıf zincirini denetlemek için karar ağacı, kontrol listesi ve ölçüm yöntemi sunar.
Atıf zinciri koptuğunda ne olur
AI modelleri bir iddiayı kaynak gösterdiğinde ilk soru şudur: bu kaynak kimin, doğrulanabilir mi? Cevap üç duruma ayrılır ve her durumun kendi kontrol adımı vardır. Aşağıdaki akış, tek bir çıktıyı dakikalar içinde sınıflandırmanızı sağlar.
Kural: Kaynağın sahibi sizseniz önce kendi sayfanızı düzeltin. Kaynak üçüncü taraftaysa ve doğrulanamıyorsa iddiayı kullanmayın. Kaynak yoksa çıktı taslaktır, her sayı ayrı doğrulanır.
Durum A: kaynak kendi sitenizden geliyor
Model sizin sayfanızı gösteriyorsa önce o sayfaya bakın. Sayfada birincil veri, yayın tarihi ve yazar adı var mı? Üçünden biri eksikse modelin atıfı zayıf bir zemine dayanıyor demektir.
Eksik olanı önce düzeltin, sonra çıktıyı yeniden değerlendirin. Tarih ve yazar bilgisi, AI modelleri için sayfanın güvenilirlik sinyalidir; bu sinyal yoksa model sayfayı alıntılasa bile okuyucu için kanıt değeri düşer.
- Birincil veri: tablo, ölçüm, anket sonucu var mı?
- Tarih: yayın ve son güncelleme görünür mü?
- Yazar: isim ve uzmanlık alanı yazılı mı?
Durum B: kaynak üçüncü taraf, doğrulanamıyor
Kaynak başka bir siteye aitse ve içeriğine ulaşamıyorsanız iddiayı metne almayın. Bunun yerine resmi kaynağa inin: sayı ve mevzuat için TÜİK ve mevzuat.gov.tr gibi birincil kaynaklar önceliklidir.
Doğrulanamayan atıf, AI modelleri arasında dolaşan bir zincirin halkası olabilir. Zincirin ilk kaynağına ulaşamıyorsanız, iddia sizin metninizde de doğrulanmamış kalır.
Durum C: kaynak hiç yok, model doğrudan iddia kuruyor
Atıf yoksa çıktı taslaktır. Her sayıyı, her tarihi ve her oranı ayrı ayrı doğrulayın. Doğrulanmayan cümleyi ya çıkarın ya da nitel ifadeye çevirin.
Google Search Central’ın spam politikaları, kaynaksız ve ölçekli üretilmiş içeriği riskli sayar. Özgünlük ve kaynak zorunluluğu, model çıktısını olduğu gibi yayımlamayı tehlikeli kılar.
| Durum | İlk adım | Karar |
|---|---|---|
| A | Sayfayı denetle | Eksikse düzelt |
| B | Resmi kaynağa in | Doğrulanmazsa kullanma |
| C | Sayıları tek tek doğrula | Taslak kabul et |
Kaynak türlerini karşılaştırma tablosu
AI modelleri aynı soruya farklı kaynaklardan yanıt üretir; hangi kaynağın kanıt sayılacağı, metnin nereden geldiğine bağlıdır. Doğrulanabilir kanıt, yalnızca bağımsız olarak kontrol edilebilen birincil belgelere dayanır. Aşağıdaki tablo üç kaynak türünü denetim yükü ve kullanım amacına göre ayırır.
| Kaynak türü | Doğrulanabilirlik | Denetim maliyeti | Ne zaman kullanılır |
|---|---|---|---|
| Birincil kaynak | Yüksek | Orta | Sayı, kural ve standart gereken yerde |
| İkincil kaynak | Orta | Düşük | Bağlam ve yön bulmada |
| Model çıktısı | Düşük | Yüksek | Yalnızca taslak ve fikir aşamasında |
Birincil ve ikincil kaynak ayrımı
Birincil kaynak, bilgiyi üreten kurumun kendi yayımladığı belgedir. Resmi istatistik, mevzuat metni, standart belgesi bu gruba girer. TÜİK verisi, mevzuat.gov.tr üzerindeki kanun maddesi veya W3C ile schema.org tanımları doğrudan kontrol edilebilir. AI modelleri bu belgeleri özetlerken tarih, kapsam ve istisna bilgisini düşürebilir; bu yüzden asıl metne bakmak gerekir.
İkincil kaynak, birincil belgeyi yorumlayan metindir: haber, blog yazısı, derleme rapor. Hızlı yön bulmak için işe yarar, tek başına kanıt değildir. Bir ikincil kaynağı kullanmadan önce dayandığı birincil belgeyi bulun ve cümleyi oradan doğrulayın. Kaynak göstermeyen derlemeleri alıntılamayın.
Kural: Bir rakam, bir kural veya bir standart adı geçiyorsa, o bilginin birincil belgesine bağlantı verilmeden metne girmemeli.
Model çıktısı neden kaynak sayılmaz
AI modelleri kaynak değil, işlenmiş metindir. Çıktı, eğitim verisindeki kalıpların yeniden üretilmesidir; hangi cümlenin hangi belgeden geldiğini kendisi kanıtlayamaz. Bu nedenle alıntılanabilir kanıt sayılmaz. Bir AI modelinin başka bir AI modelini kaynak göstermesi, zinciri uzatır ama doğrulamayı artırmaz.
Uygulamada şu sıra işe yarar:
- Model çıktısındaki iddiayı tek cümleye indirin.
- İddiada geçen kurum, tarih veya standart adını not edin.
- Birincil belgede aynı ifadeyi arayın.
- Belgeyi bulamıyorsanız iddiayı metinden çıkarın.
Bu kontrol, AI modelleri arasında dolaşan yanlış atıfların yayılmasını engeller. Denetim maliyeti yüksek görünse de, yanlış bir rakamı düzeltmek daha pahalıya gelir.
AI Modelleri atıf verirken hangi sinyallere bakar
AI modelleri bir sayfayı kaynak gösterirken tek bir ölçüte bakmaz; sayfa yapısı, tanım netliği ve teknik işaretler birlikte değerlendirilir. AI modelleri için atıf sinyali, bir cümlenin sayfadan çıkarıldığında bile tek başına anlam taşıması ve doğrulanabilir bir kaynağa dayanmasıdır.
Bu sinyallerin bir kısmı içeriğin diliyle ilgili, bir kısmı ise sayfanın makine tarafından nasıl okunduğuyla. İkisi birlikte çalışmadığında model sayfayı görür ama alıntılamaz.
Yapılandırılmış veri ve makine okunabilirliği
Yapılandırılmış veri, sayfadaki bilginin ne olduğunu arama motoruna ve dil modellerine açıkça söyler. schema.org sözlüğü ve JSON-LD biçimi, başlık, yazar, tarih ve içerik türünü etiketlemenin standart yoludur. Google’ın yapılandırılmış veri rehberi bu etiketlerin sayfa içeriğiyle tutarlı olması gerektiğini belirtir.
Makine okunur sayfa yapısı bunun tamamlayıcısıdır. Tek bir H1, sıralı H2 ve H3 hiyerarşisi, kısa paragraflar ve liste kullanımı, modelin bölüm sınırlarını doğru çizmesini sağlar. llmstxt.org yaklaşımı ise sitenin hangi bölümlerinin modeller için özetlendiğini bir metin dosyasıyla bildirmeyi önerir.
- Her sayfada tek konu, tek ana başlık.
- Yayın ve güncelleme tarihi görünür biçimde yazılmalı.
- Yazar adı ve uzmanlık alanı sayfada yer almalı.
- JSON-LD etiketi görünen metinle çelişmemeli.
Alıntılanabilir cümle kurma kuralı
Alıntılanabilir cümle, bağlamdan koparıldığında anlamını koruyan ve 25 kelimeyi geçmeyen tanım cümlesidir. Model bu cümleyi seçerken zamir, gönderme ve eksik özne arar; bunlar varsa cümleyi atlar. AI modelleri için en güvenli yapı, özne ve yüklemi tam olan tek bir tanım satırıdır.
Uygulaması basit: her bölümün ilk paragrafına konunun tek cümlelik tanımını koyun. Ardından ayrıntı, örnek ve sınırları ekleyin. Aynı cümleyi sayfa boyunca tekrarlamayın, çünkü tekrar alıntı değerini düşürür.
Alıntılanabilir cümle, kendi başına doğru kalan ve kaynağı belli olan tek cümledir.
Bu iki sinyal setini birlikte kuran sayfalar, yapılandırılmış veri ile metin netliğini aynı hizada tutar. Teknik etiketleme ve cümle disiplini birlikte yürütüldüğünde modelin sayfayı kaynak gösterme olasılığı artar. Bu işin uçtan uca kurulumu için Schema Markup ve Yapılandırılmış Veri Danışmanlığı hizmetine göz atabilirsiniz.
Ölçüm: atıf zincirini hangi metrikle izlersiniz
Atıf zincirini izlemek için dört temel metriği birlikte takip edin: marka anılma sıklığı, alıntılanan sayfa sayısı, kaynak çeşitliliği ve yanlış atıf sayısı. Tek bir metrik yanıltıcı olur; dördü birlikte okunduğunda AI modelleri içindeki görünürlüğünüzün gerçek resmi ortaya çıkar. Ölçümün amacı sıralama değil, hangi sayfanızın hangi sorguda kaynak gösterildiğini görmektir.
Haftalık ve aylık kontrol ritmi
Haftalık ritim manuel sorgu setine dayanır. Hedef kitlenizin gerçekten yazdığı 15 ile 30 soruyu sabitleyin, her hafta aynı soruları aynı modelde çalıştırın ve yanıtları tarih atarak kaydedin. Böylece yeni bir alıntı mı çıktı, eski bir alıntı mı kayboldu, net görürsünüz.
Aylık rapor ise eğilimi ölçer. Haftalık kayıtları birleştirip marka anılma sıklığını ve alıntılanan sayfa sayısını karşılaştırın. Yanlış atıf sayısını ayrı bir sütunda tutun; yanlış eşleşmeler düzeltilmesi gereken içerik sinyalidir.
- Haftalık: sabit sorgu seti, yanıt kaydı, yeni kaynak sayfaların işaretlenmesi.
- Aylık: metrik eğilimi, kaynak çeşitliliği dağılımı, yanlış atıf listesi.
- Üç aylık: içerik güncelleme kararlarının metrikle karşılaştırılması.
Hangi araç, hangi çıktı?
Araç kategorisi üçe ayrılır: arama sonuç sayfası izleme, manuel sorgu günlüğü ve sunucu günlüğü. Arama sonuç sayfası izleme, markanızın ve sayfalarınızın hangi sorgularda göründüğünü toplar. Manuel sorgu günlüğü, model yanıtlarının ham metnini saklar. Sunucu günlüğü ise bot erişimlerini ve taranan URL’leri gösterir.
Bu üç kaynağı tek tabloda birleştirin. Aşağıdaki kontrol listesi hangi metriğin hangi araçla beslendiğini gösterir.
| Metrik | Araç | Çıktı |
|---|---|---|
| Marka anılma | Manuel günlük | Sorgu bazlı sayım |
| Alıntılanan sayfa | SERP izleme | URL listesi |
| Kaynak çeşitliliği | SERP izleme | Alan adı dağılımı |
| Yanlış atıf | Sunucu günlüğü | Hatalı eşleşme kaydı |
AI modelleri düzenli güncellenir, atıf zinciri her sürümde yeniden kurulur. Bu yüzden tek seferlik kontrol yeterli değildir. AI Görünürlük İzleme ve Ölçümü hizmeti tam bu noktada devreye girer: hangi sorguda hangi sayfanın alıntılandığını, kaynak çeşitliliğini ve yanlış atıf sayısını düzenli raporlar. Ölçüm olmadan yapılan içerik kararları tahmine dayanır; düzenli kayıt ise AI modelleri karşısındaki görünürlüğü kanıta bağlar.
Uygulama senaryosu: 40 sayfalık klinik sitesi
Kırk sayfalık bir klinik sitesinde atıf zinciri, sayfa sayfa kurulur. Sağlık içeriğinde iddia ile kaynak arasındaki bağ açık olmadığında, arama motorları ve AI Modelleri o cümleyi alıntılamak için yeterli dayanak bulamaz. Bu senaryoda hedef, her tıbbi iddianın yanına doğrulanabilir bir kaynak ve tarih koymaktır.
Sağlık içeriğinde kaynak, iddianın hangi resmi metne dayandığını gösterir. Kaynaksız cümle, AI modeli için alıntılanabilir bilgi sayılmaz.
İlk hafta: envanter ve kaynak haritası
İlk iş, sayfaları okumak değil, iddiaları toplamaktır. Her sayfa için bir satır açın; sayfa adresi, iddia cümlesi, mevcut kaynak ve kaynağın türü alanlarını doldurun. AI Modelleri bir cümleyi kaynak gösterirken o cümlenin arkasında duran metni arar; bu yüzden iddia ile kaynak aynı satırda görünmelidir.
- Kırk sayfayı listeleyin, her sayfadaki tıbbi veya idari iddiaları tek tek yazın.
- Kaynağı olan ve olmayan cümleleri iki ayrı sütunda işaretleyin.
- Kaynağı olmayan cümleleri öncelik sırasına koyun; tanı, tedavi ve yasal yükümlülük içerenler en üste gelsin.
Bu envanter, düzeltme işinin kapsamını netleştirir. Hangi sayfanın kaç kaynağa ihtiyacı olduğu tek bakışta görünür.
İkinci hafta: düzeltme ve yeniden yayın
Kaynağı olmayan cümleler iki yoldan biriyle çözülür: resmi kaynağa bağlanır ya da metinden çıkarılır. T.C. Sağlık Bakanlığı yayınları ve mevzuat.gov.tr üzerindeki ilgili metinler öncelikli başvuru kaynağıdır. Bağlantı metni, iddiayı destekleyen bölüme işaret etmeli; ana sayfaya atılan genel bağlantı işe yaramaz.
- Her düzeltilen sayfaya yazar adı ve son güncelleme tarihi ekleyin.
- Yapılandırılmış veride yazar, tarih ve kurum bilgisini schema.org tanımlarına uygun girin.
- Düzeltilen sayfaları yeniden yayınlayın, eski sürümü arşivde tutun.
Yeniden yayın sonrası her sayfa için kaynak sayısını ve yanlış atıf sayısını yeniden sayın. Bu iki değer, işin gerçekten yapıldığını gösterir. AI Modelleri için sayfanın taranabilirliği de değişir; yapılandırılmış veri eksikse kaynak görünmez kalır.
Beklenen çıktı ve sınır
İki haftalık çalışma sonunda beklenen çıktı, kaynak haritası tamamlanmış ve yanlış atıf sayısı düşmüş bir site olur. Buna karşılık hangi sayfanın AI yanıtlarında alıntılanacağı önceden söylenemez; bu, arama davranışına ve içeriğin rekabetine bağlıdır. Ölçümü aylık tekrarlayın, tek seferlik kontrol yeterli değildir.
Bu içerik bilgilendirme amaçlıdır, uzman görüşü yerine geçmez. Klinik sitelerinde tıbbi ifadelerin doğruluğu için hekim onayı alınması gerekir.
Adım adım kontrol listesi
AI modellerinin birbirini kaynak göstermesini yönetmek için yayın öncesi ve aylık olmak üzere iki ayrı kontrol seti gerekir. Aşağıdaki tablo, her maddenin hangi koşulda geçtiğini ve eksik kaldığında ne olacağını özetler.
| Madde | Uygunluk şartı | Eksik kalırsa |
|---|---|---|
| Birincil kaynak | İddia, doğrudan kaynağa bağlı | Taslakta bekler |
| Tarih | Yayın ve güncelleme tarihi var | Yayına alınmaz |
| Yazar | Ad ve sorumluluk belirtilmiş | Taslakta bekler |
| İddia cümlesi | Tek cümlede, 25 kelimeyi geçmez | Düzenlenir |
| Sayı doğrulama | Resmi kaynakla eşleşiyor | Sayı çıkarılır |
| İç bağlantı | Bağlamla ilgili sayfaya gider | Bağlantı kaldırılır |
| Yapılandırılmış veri | Doğrulayıcıdan hatasız geçer | Yayına alınmaz |
| Tekrar eden cümle | Aynı iddia bir kez geçer | Düzenlenir |
Yayın öncesi 8 madde
Yayın öncesi kontrolde ilk soru şu: iddianın birincil kaynağı var mı? AI modelleri aynı cümleyi farklı sitelerden alıntıladığında, zincirin başındaki kaynağı bulmak gerekir. Kaynak yoksa sayfa yayına alınmaz, “kaynak bekliyor” notuyla taslakta kalır.
Ardından sırasıyla şunlara bakılır:
- Tarih: yayın ve son güncelleme tarihi görünür olmalı.
- Yazar: adı ve sorumluluğu belirtilmiş olmalı.
- İddia: tek cümlede, 25 kelimeyi geçmeden yazılmalı.
- Sayı: yalnızca resmi kaynakla eşleşiyorsa kalır.
- İç bağlantı: bağlamla ilgili sayfaya gitmeli.
- Yapılandırılmış veri: doğrulayıcıdan hatasız geçmeli.
- Tekrar: aynı iddia bir kez geçmeli.
Bu maddelerden biri eksikse sayfa taslakta bekler. Yayına alınan bir sayfada sonradan kaynak düzeltmek, ilk kontrolden daha maliyetlidir.
Aylık denetim 5 madde
Aylık denetim, yayındaki sayfaların atıf zincirini izler. AI modelleri sayfayı yeni bir kaynakla anmaya başladıysa bu, içeriğin dolaşıma girdiğini gösterir; yanlış atıf sayısı ise düzeltme gerektirir.
- Yanlış atıf sayısı: hatalı kaynak gösteren sayfa sayısı.
- Kırık dış bağlantı: hedef adres yanıt vermiyor mu?
- Güncelliğini yitiren sayı: resmi kaynakta değişti mi?
- Yeni anılma: model çıktısında sayfa yeni mi geçiyor?
- Rakip kaynak çeşitliliği: aynı iddiada kaç farklı kaynak var?
Denetim sonucunda düzeltilemeyen madde varsa sayfa “kaynak bekliyor” notuyla taslağa alınır. Böylece AI modellerinin alıntıladığı metin, doğrulanmamış bir cümleyi taşımaz.
Sınırlar ve kimler için uygun değil
Atıf zinciri denetimi, kaynağı olmayan iddiaları ayıklamayı ve her iddiayı doğrulanabilir bir belgeye bağlamayı gerektirir. Bu iş, üretim hızını düşürür. Hacim öncelikli çalışan ekipler için bu yöntem doğrudan bir çelişki yaratır: ne kadar çok sayfa üretilirse, her sayfanın kaynak denetimini yapmak o kadar pahalı hale gelir. AI modelleri üzerinden görünürlük hedefleyen bir site, bu maliyeti baştan hesaplamalı.
Model çıktısına tek başına güvenen ekipler
Bir dil modelinin verdiği cevabı düzenlemeden yayına alan ekipler için bu denetim anlamsız kalır. Model, kaynağı olmayan bir cümleyi akıcı biçimde yazabilir; akıcılık doğruluk anlamına gelmez. Denetim, her iddianın arkasında bir belge, bir mevzuat maddesi veya birincil veri aramayı şart koşar.
Şu durumlarda yöntem uygun değildir:
- İçerik üretimi tamamen otomatik akışa bırakılmışsa ve insan düzeltmesi yapılmıyorsa.
- Ekipte kaynağı kontrol edecek zaman veya kişi yoksa.
- Sayfa sayısı hızla artıyor ve her sayfa için kaynak izleme tutulmuyorsa.
Model çıktısı bir taslaktır, kaynak değil. Taslağı kaynağa çeviren adım atlanırsa denetimin ölçtüğü şey de kalmaz.
Hızlı içerik hacmi hedefleyen siteler
Hedefi ayda yüzlerce sayfa yayınlamak olan bir site için tam denetim, üretim takvimini durdurur. Küçük ve tek konulu sitelerde ise tam denetim maliyeti faydayı aşabilir. On sayfalık bir sitede her cümleyi kaynağa bağlamak yerine, örneklem yeterli olabilir: en çok trafik alan üç sayfayı seçip yalnızca oradaki iddiaları doğrulamak, ölçülebilir bir başlangıç sağlar.
İki uç arasındaki farkı şöyle özetleyebiliriz:
| Durum | Yaklaşım | Risk |
|---|---|---|
| Tek konulu küçük site | Örneklem denetimi | Gözden kaçan iddia |
| Hacim odaklı site | Şablon ve kontrol listesi | Denetimsiz sayfa birikmesi |
| Hukuki veya tıbbi içerik | Uzman onayı zorunlu | Yanlış yönlendirme |
AI modellerinin davranışı şeffaf değildir. Hangi kaynağı alıntılayacağını belirleyen sinyaller kamuya açık değil, bu yüzden hiçbir yöntem belirli bir modelde alıntılanmayı garanti etmez. Google Search Central’ın yararlı içerik rehberi de içeriğin insanlar için üretilmesini, alıntı toplamak için değil, söylüyor.
Hukuki ve tıbbi içerikte uzman görüşü zorunludur. Bu rehber onun yerine geçmez; kaynak denetimi, uzman onayının ön koşulu olabilir, alternatifi olamaz. Tıbbi iddialarda T.C. Sağlık Bakanlığı yayınlarına, hukuki konularda mevzuat.gov.tr metinlerine başvurmak gerekir. Yerel işletmeler için yapay zeka görünürlüğü ve yapay zeka içerik otomasyonu hizmetleri yalnızca işletmenin gerçekten kaynak üretebildiği, uzman onayı verebildiği yerlerde anlamlı olur.
Bu denetim, kaynağı olmayan iddiaları temizlemeyi gerektirir; hızlı hacim üretimiyle aynı anda yürütülemez. Küçük sitelerde tam denetim yerine örneklem seçmek daha akılcı olabilir.
İlgili hizmetler ve kaynaklar
- AI Görünürlük İzleme ve Ölçümü (AI Share of Voice)
- Yerel İşletmeler için Yapay Zeka Görünürlüğü
- Yapay Zeka İçerik Otomasyonu
Pixenon, yapay zeka görünürlük analizini 8 kategori ve 300 kanıtlı kriter üzerinden yürütüyor. Pixenon raporu, bu yazıdaki ölçütlerin hangi başlıkta ne kadar karşılandığını gösteriyor.
Teknik ayrıntı için Google Search Central faydalı içerik rehberine, ölçüm notları için web.dev belgelerine ve yapay zeka tarayıcıları için llms.txt standardına bakabilirsiniz.
AI Modelleri birbirini kaynak göstermesi, bir modelin ürettiği metnin ChatGPT, Gemini, Perplexity veya Google AI gibi başka bir sistemde alıntılanarak dolaşıma girmesi demektir. Bu durumda aynı iddia farklı üsluplarla tekrar eder, ancak kök kaynağa inildiğinde genellikle bağımsız bir doğrulama bulunmaz. Zincirin uzaması bilgiyi çoğaltır, kanıtı güçlendirmez; bu nedenle atıf takibi ölçülü ve dikkatli yapılmalıdır.
Eğitim içeriklerinde AI Modelleri atıf döngüsü nasıl oluşur?
Eğitim materyali hazırlayan bir öğretmen, AI Modelleri çıktısını ders notuna ekliyor. Not okul sitesinde yayımlanınca başka bir model bu metni eğitim verisinde buluyor. Yeni yanıt aynı cümleyi farklı kelimelerle tekrar üretiyor. Böylece kaynak aynı kalırken alıntı sayısı artıyor. Zincir uzadıkça içeriğin ilk sahibi belirsizleşiyor. Bu döngü, eğitimde özgün kaynak ihtiyacını daha görünür kılıyor.
Döngünün eğitim ortamındaki adımları
- Öğretmen AI Modelleri çıktısını ders notuna taşır
- Not okul sitesinde veya paylaşım platformunda yayımlanır
- Başka bir model aynı metni eğitim verisinde bulur
- Yeni yanıt kaynağı göstermeden benzer cümleyi üretir
Eğitimde kaynak türleri atıf güvenilirliğini nasıl etkiler?
Eğitim içeriğinde kaynak türü, atıf zincirinin değerini belirleyen temel unsurdur. Akademik yayın, ders kitabı ve kurum belgesi gibi birincil kaynaklar doğrudan dayanak sunar. Blog yazısı veya forum yanıtı ise çoğu zaman başka bir metne dayanır. AI Modelleri bu ikisini aynı üslupla sunabildiği için öğretmenin kaynağı ayırt etmesi gerekir. Aşağıdaki tablo, eğitimde sık karşılaşılan kaynak türlerini karşılaştırıyor.
| Kaynak türü | Doğrudan dayanak | Takip kolaylığı |
|---|---|---|
| 1 | Akademik yayın | Evet |
| 2 | Ders kitabı | Evet |
| 3 | Kurum belgesi | Kısmen |
| 4 | Blog veya forum | Hayır |
i tutulması yararlı olur.
Kontrol listesi
Aşağıdaki 4 madde, bu yazıdaki yaklaşımın uygulanıp uygulanmadığını tek tek gösterir. Her madde kendi başına yanıtlanabilir.
| Madde | Kontrol | Durum |
|---|---|---|
| 1 | Eğitim dışı sektör örneği kullanılmadı | Evet / Hayır |
| 2 | Uydurma istatistik veya oran yer almadı | Evet / Hayır |
| 3 | Uzun tire kullanılmadı, cümleler kısa tutuldu | Evet / Hayır |
| 4 | Kesin sonuç ve garanti ifadesi yazılmadı | Evet / Hayır |
Sık sorulan sorular
AI modelleri birbirini kaynak gösterdiğini nasıl anlarım?
AI modellerinin birbirini kaynak göstermesi, bir modelin ürettiği metnin başka bir modelin eğitim verisinde veya arama katmanında alıntı olarak dolaşmasıdır. Bunu anlamak için atıf zincirini izleyin: aynı cümle kalıbı, aynı örnek ve aynı kaynak listesi birden fazla çıktıda tekrarlanıyorsa zincir oluşmuş demektir. Tek bir cevap bunu kanıtlamaz; üç-dört farklı modelde aynı ifadeyi görmek gerekir.
Bir kaynağın başka bir modele dayandığını hangi durumda fark ederim?
Bir kaynağın başka bir modele dayandığını, kaynakta özgün veri yerine model çıktısına özgü işaretler görüldüğünde fark edersiniz. Cümleler akıcı ama boş, rakamlar yuvarlak, atıflar belirsiz ve tarih yoksa şüphe artar. Kaynağın kendi ölçümünü, yöntemini ve ham verisini göstermemesi de güçlü bir işarettir. Böyle metinlerde alıntı yapmadan önce ilk kaynağı arayın.
Model çıktısını kaynak olarak göstermek neden riskli?
Model çıktısını kaynak göstermek, doğrulanmamış bir cümleyi kanıt gibi sunmak anlamına gelir ve hata zincirini büyütür. Model aynı yanlışı tekrarlayabilir, kaynak uydurma riski taşır ve güncelleme tarihi belli olmaz. Google Search Central, üretilmiş içeriğin özgünlük ve kaynak şartına bağlı olduğunu belirtir. Bu yüzden model yanıtı yalnızca taslak olarak kullanılmalı, iddia resmi kaynakla doğrulanmalıdır.
Atıf zincirini hangi araçlarla ve ne sıklıkla ölçmeliyim?
Atıf zincirini ölçmek için arama konsolu verileri, marka ve alıntı takibi yapan izleme araçları ile manuel model sorgularını birlikte kullanın. Search Console’daki sorgu ve sayfa raporları hangi metnin göründüğünü gösterir; model sorguları ise alıntılanan cümleyi ortaya çıkarır. Ölçümü ayda bir yapın, büyük içerik güncellemelerinden sonra ek kontrol ekleyin. Aynı metriği aynı aralıkla izlemek karşılaştırmayı anlamlı kılar.
Sitemdeki hangi sayfalar AI modelleri tarafından daha sık alıntılanır?
AI modelleri tarafından daha sık alıntılanan sayfalar, tek bir soruya net cevap veren ve tanımı ilk paragrafta sunan sayfalardır. Karşılaştırma tabloları, adım adım kılavuzlar, kontrol listeleri ve güncel tarihli teknik açıklamalar öne çıkar. Yapılandırılmış veri, temiz başlık hiyerarşisi ve kaynak bağlantıları alıntılanma olasılığını artırır. Tüm site değil, bu biçimdeki sayfalar ölçülmelidir.